"Queremos treinar uma IA com os nossos dados." É um pedido cada vez mais comum, e quase sempre quer dizer outra coisa: a empresa quer um assistente que conheça os produtos, fale com o tom da marca e não invente política de troca. Isso é legítimo. O problema é a palavra "treinar", que puxa a conversa para um projeto de aprendizado de máquina caro, demorado e, na maioria dos casos, desnecessário.
Este texto separa os três sentidos de "treinar IA", mostra o que cada um resolve e explica por que uma notícia recente, o fechamento da plataforma de ajuste fino da OpenAI a novos usuários, reforça o caminho que já era o mais sensato: preparar a base da marca antes de pagar por qualquer treino.
O que é treinar IA?
No sentido técnico, treinar uma IA é ajustar os parâmetros internos de um modelo a partir de exemplos, até que ele passe a produzir as respostas esperadas. É assim que nascem os grandes modelos de linguagem: leem uma quantidade enorme de texto e, nesse processo, "guardam" padrões de língua e de conhecimento dentro de si.
No uso do dia a dia, porém, "treinar a IA" virou sinônimo de qualquer coisa que faça o assistente saber algo sobre a empresa. Subir um PDF num chat, escrever instruções, conectar o catálogo, tudo isso costuma ser chamado de treino. A diferença parece semântica, mas decide orçamento, prazo e quem precisa estar no projeto.
A documentação da Anthropic traça essa linha com clareza. Ela separa o grande conjunto de dados com que o modelo foi treinado da janela de contexto, o texto que o modelo consulta ao responder.
Treino muda o que o modelo é. Contexto muda o que o modelo lê naquele momento. Quase tudo o que uma empresa quer de uma "IA treinada com os nossos dados" se resolve na segunda camada.
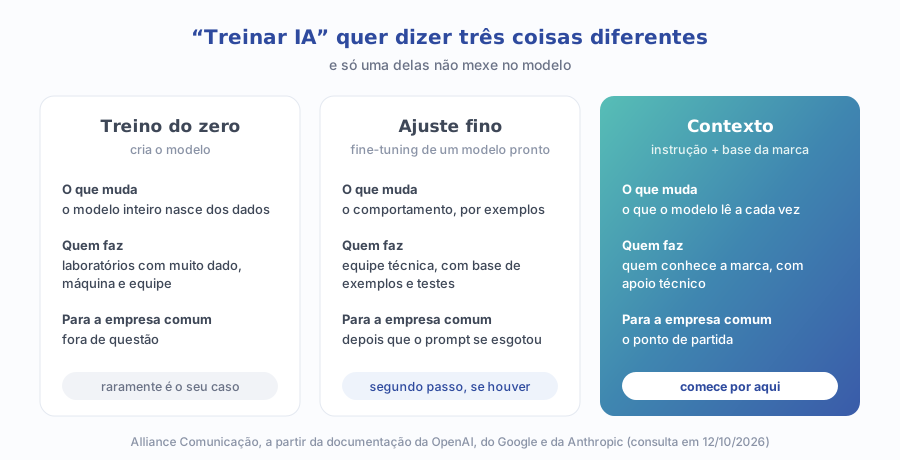
Quais são os três sentidos de "treinar" uma IA?
Quando alguém diz que vai treinar uma IA, pode estar falando de três coisas muito diferentes. Vale nomeá-las antes de qualquer orçamento.
1. Treino do zero
É criar o modelo. Exige volume gigantesco de dados, infraestrutura de computação e equipe especializada, e é o que fazem os laboratórios que desenvolvem os modelos de base. É o sentido que aparece nos glossários de aprendizado de máquina e nos guias de infraestrutura. Para uma empresa que quer um assistente que conheça a sua marca, não é uma opção real.
2. Ajuste fino (fine-tuning)
É pegar um modelo pronto e continuar o treino dele com exemplos da empresa: pares de pergunta e resposta, textos no formato desejado, classificações. O modelo resultante passa a se comportar de um jeito mais específico. É útil para comportamento repetitivo e formato consistente, mas é um jeito lento e caro de ensinar fatos: se o preço mudou, é preciso treinar de novo.
3. Contexto: instrução e base de conhecimento
É não mexer no modelo e mudar o que ele recebe. A cada pergunta, o sistema entrega instruções (quem o assistente é, como fala, o que pode e não pode dizer) e o conteúdo da empresa que ele deve consultar. Quando a base é grande, uma busca escolhe os trechos certos, a técnica chamada RAG, que explicamos em o que é RAG em IA e quando a empresa nem precisa dele.
O que mudou com o fim do ajuste fino na OpenAI?
Durante anos, "treinar o ChatGPT com os dados da empresa" teve um caminho técnico concreto: a plataforma de ajuste fino da OpenAI, em que desenvolvedores enviavam exemplos e recebiam uma versão personalizada de um modelo. Esse caminho está sendo encerrado.
Na mesma página, a OpenAI diz que o processo de engenharia de prompt pode ser tudo de que o caso de uso precisa para obter ótimos resultados, e que o ajuste fino pode ser um processo demorado. O fluxo de trabalho que ela recomenda começa por escrever avaliações (testes que medem a saída do modelo) e por instruir o modelo com contexto e dados relevantes; o ajuste fino aparece como algo desejável apenas "para alguns casos de uso".
A OpenAI não está sozinha nessa ordem. O Google, que mantém o ajuste fino dos modelos Gemini na sua plataforma de nuvem, escreve na documentação de ajuste de modelos que recomenda começar pelo prompt para encontrar a melhor instrução e só depois partir para o ajuste fino, se necessário, para melhorar o desempenho ou corrigir erros recorrentes.
Duas leituras saem daí. A primeira: o ajuste fino não acabou no mercado, e quem já tem um projeto sério dele em outro fornecedor não precisa entrar em pânico. A segunda, mais importante para quem está começando: quem desenvolve os modelos diz, por escrito, que o primeiro passo é instrução e contexto. Fornecedor que vende "treino" como ponto de partida está pulando etapa.
Qual a diferença entre treinar a IA e dar contexto a ela?
A diferença prática aparece em quatro perguntas que todo projeto vai enfrentar: como atualizar, como saber de onde veio a resposta, quanto esforço exige e quem consegue manter.
| Treino do zero | Ajuste fino | Contexto (instrução + base) | |
|---|---|---|---|
| O que muda | o modelo inteiro | o comportamento de um modelo pronto | o que o modelo lê a cada pergunta |
| Serve melhor para | criar um modelo novo | formato e estilo repetitivos | fatos da empresa, tom e regras |
| Quando o preço muda | não se aplica | treinar de novo | trocar o texto da base |
| Mostra de onde veio a resposta? | não | não | sim, se a instrução pedir |
| Quem mantém | laboratório de IA | equipe técnica | quem conhece a marca, com apoio técnico |
| Disponível na OpenAI hoje | não se aplica | fechado a novos usuários | sim |
Comparativo da Alliance a partir da documentação da OpenAI (Model optimization), do Google (ajuste de modelos) e da Anthropic (Context windows), consultadas em 12/10/2026
A linha que mais pesa é a de atualização. Uma marca muda tabela, lança produto, revê política. No contexto, isso é edição de texto. No ajuste fino, é um novo ciclo de treino, com o risco de o modelo continuar "lembrando" a versão antiga com toda a confiança, o tipo de erro que discutimos em alucinação de IA: por que o assistente inventa sobre a sua empresa.
Há um cuidado com o contexto também: mais não é sempre melhor. A mesma documentação da Anthropic registra que, à medida que o número de tokens cresce, a precisão e a capacidade de recuperar informação caem, fenômeno que ela chama de context rot, e conclui que escolher o que entra no contexto importa tanto quanto o espaço disponível. Despejar o drive inteiro da empresa no assistente não é base de conhecimento: é ruído.
Como treinar uma IA com os dados da sua empresa, na prática?
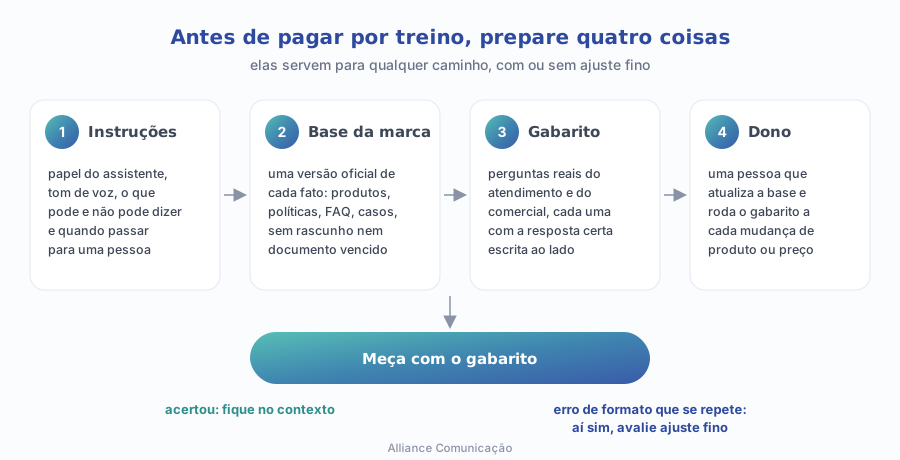
Usando a palavra no sentido que a empresa quer dizer, "fazer a IA conhecer a marca", o trabalho tem cinco etapas. Nenhuma delas exige ajuste fino.
1. Defina o trabalho do assistente
Atender clientes no site, responder dúvidas do time comercial, redigir posts no tom da marca: cada uso pede uma base e uma instrução diferentes. Um assistente que "faz tudo" costuma fazer tudo pela metade. Escreva numa frase para quem ele responde e o que entrega.
2. Escreva as instruções como se fossem para um funcionário novo
Papel, público, tom, o que nunca dizer, quando admitir que não sabe, quando passar para uma pessoa. Adjetivos como "próximo" e "inovador" não orientam ninguém; exemplos de frase certa e errada orientam. O método está detalhado em como escrever o guia de tom de voz que a IA e a equipe conseguem seguir.
3. Monte a base da marca, com uma versão oficial de cada fato
Produtos e serviços, perguntas frequentes, políticas, diferenciais, casos, quem atende o quê. Cada informação em um lugar só, com data de revisão. Proposta vencida, rascunho e apresentação antiga ficam de fora: se a base tem duas versões do prazo de entrega, a IA vai escolher uma, e nem sempre a certa.
4. Escolha onde a base vai morar
Para uso interno, os próprios aplicativos de IA já aceitam instruções e arquivos (veja a seção seguinte). Para atendimento ao cliente, a base vai para a ferramenta de atendimento ou para um sistema próprio que a envia ao modelo. Base pequena pode ir inteira; base grande pede busca, o RAG. Informação que muda toda hora, como estoque e preço, deve ser consultada no sistema de origem, não copiada para um texto.
5. Teste com perguntas reais antes de abrir para o público
Junte perguntas que o atendimento e o comercial realmente recebem, escreva a resposta certa ao lado e rode todas. É o mesmo princípio que a OpenAI coloca no início do fluxo dela: medir antes de otimizar. Só depois desse teste existe base para decidir se algo mais é necessário.
Como fazer isso no ChatGPT, no Claude e no Gemini?
Nos aplicativos de uso direto, "treinar" quase sempre significa criar um espaço com instruções fixas e arquivos de referência. O nome do recurso muda de fornecedor para fornecedor, e os recursos mudam com frequência, então confira na ajuda oficial do aplicativo que a empresa usa.
- Claude: os Projetos são espaços com histórico e base de conhecimento próprios, onde é possível enviar documentos e definir instruções para o projeto. Segundo a central de ajuda do Claude, estão disponíveis para todos os usuários, inclusive nas contas gratuitas.
- Gemini: os Gems aceitam nome, instruções e arquivos para dar mais contexto. A ajuda do Google avisa que, a partir de novembro de 2026, os Gems deixam de existir em contas pessoais do Google e passam automaticamente a ser "skills". Se a sua base está num Gem de conta pessoal, guarde uma cópia das instruções e dos arquivos.
- ChatGPT: no aplicativo, o caminho também é instrução e arquivos, nos recursos que o seu plano oferece. O ajuste fino, que era feito pela plataforma de desenvolvedores, não está mais aberto a novos usuários.
O detalhe que importa é que, nos três casos, o modelo não muda. Ele lê o que você deixou ali a cada conversa. Por isso a qualidade do resultado depende muito mais do texto das instruções e da arrumação dos arquivos do que da ferramenta escolhida, e a mesma base bem escrita pode ser levada de uma ferramenta para outra.
Quando o ajuste fino ainda faz sentido?
Descartar o ajuste fino por princípio seria o erro oposto. Ele continua existindo em outros fornecedores e tem lugar quando três condições aparecem juntas.
- O contexto já foi esgotado. As instruções foram reescritas, a base está limpa, o gabarito foi rodado, e o erro persiste.
- O erro é de comportamento, não de fato. Formato de saída que escapa, classificação inconsistente, estilo que não fixa. É o que o Google descreve como corrigir erros recorrentes e obter resultados mais consistentes.
- Há volume e equipe para sustentar. Ajuste fino pede conjunto de exemplos curado, testes a cada nova versão do modelo e alguém responsável por refazer o ciclo.
Se o problema é "a IA não sabe o preço do plano novo", ajuste fino é o remédio errado: isso é fato, e fato vai na base. Se o problema é "a IA não segue o formato do relatório que o cliente exige, mesmo com exemplos na instrução", aí vale conversar sobre ajuste fino.
Quanto custa treinar uma IA?
Depende de qual dos três sentidos está em jogo, e a diferença é de natureza, não só de valor. Treino do zero é investimento de laboratório, fora do alcance e do interesse da empresa comum. Ajuste fino soma o custo de preparar os exemplos, o de treinar e o de manter, com novo ciclo a cada mudança relevante.
No caminho do contexto, o maior custo é editorial: o tempo de quem escreve as instruções e organiza a base, mais o consumo do modelo a cada pergunta. É o mesmo raciocínio que detalhamos em quanto custa um agente de IA, em que a conta de uso cresce junto com o número de conversas.
Desconfie de orçamento que começa pelo treino. Se ninguém perguntou quais documentos existem, quem é o dono deles e quais perguntas o assistente precisa acertar, o preço está sendo calculado sobre o trabalho errado.
Quais erros mais aparecem quando a empresa quer "treinar" a IA?
- Contratar ajuste fino para ensinar fatos que mudam, como preço, estoque e condições comerciais.
- Subir todos os arquivos do drive, com versões antigas e rascunhos, e esperar que a IA saiba qual vale.
- Escrever instruções em adjetivos ("seja simpático e inovador") em vez de regras e exemplos.
- Testar com três perguntas inventadas pela equipe técnica, em vez de dezenas de perguntas reais de clientes.
- Deixar a base sem dono: o assistente está certo no lançamento e errado três meses depois.
- Confundir "treinar a IA com os nossos dados" com o outro sentido do termo, o de plataformas que usam dados de usuários para treinar os próprios modelos. Esse é um tema de privacidade e de contrato com o fornecedor, que precisa ser checado à parte.
Os três primeiros erros têm a mesma raiz: tratar como problema técnico o que é, antes, um problema de conteúdo. Uma base enxuta, com uma resposta oficial para cada pergunta, resolve mais do que qualquer configuração.
Como medir se a IA aprendeu a sua marca?
"Aprender", aqui, quer dizer responder certo, no tom certo, e admitir quando não sabe. Dá para medir as três coisas com o gabarito de perguntas reais.
| O que medir | Como medir | O que fazer se falhar |
|---|---|---|
| Acerto de fatos | comparar cada resposta com a resposta oficial do gabarito | corrigir ou completar a base, não o modelo |
| Fonte da resposta | pedir na instrução que o assistente cite o documento | remover duplicidades e versões antigas |
| Tom de voz | revisão por quem cuida da marca, com exemplos de certo e errado | reescrever a instrução com exemplos |
| Recusa honesta | incluir no gabarito perguntas cuja resposta não está na base | instruir a dizer que não sabe e passar para uma pessoa |
| Estabilidade | rodar o mesmo gabarito a cada mudança de base ou de modelo | nomear um dono e uma rotina de revisão |
Método da Alliance, alinhado ao fluxo de avaliação recomendado pela OpenAI (Model optimization, consultado em 12/10/2026)
Se depois disso sobrar um erro que se repete e que nenhuma reescrita de instrução corrige, você terá algo que quase ninguém tem quando contrata treino: a prova de que o contexto se esgotou e um conjunto de exemplos pronto para um eventual ajuste fino.
Por onde começar hoje
- Escreva numa frase o trabalho do assistente: para quem ele responde e o que entrega.
- Liste os documentos que ele precisa consultar e descarte o que está vencido ou duplicado.
- Escreva as instruções com regras e exemplos de frase, incluindo quando dizer "não sei".
- Monte um gabarito com perguntas reais do atendimento e do comercial, cada uma com a resposta certa.
- Rode o gabarito no aplicativo que a empresa já usa, antes de contratar qualquer treino.
- Nomeie um dono para a base e uma data fixa de revisão.
A peça que mais decide o resultado é a base da marca: enxuta, correta e com dono. É o trabalho que fazemos na base de conhecimento de marca para IA, a mesma base que alimenta os seus assistentes e que você leva de uma ferramenta para outra quando o fornecedor muda as regras, como acabou de acontecer com o ajuste fino. Se ainda não está claro em que ponto a sua operação está, o diagnóstico gratuito de marketing mede a maturidade em tecnologia e dados junto com as outras áreas. Do diagnóstico à ação.