Quase todo projeto de IA com os documentos da empresa chega à mesa com a mesma palavra: RAG. O fornecedor fala em banco vetorial, em embeddings, em pipeline de recuperação — e a conversa pula direto para a arquitetura, como se a decisão já estivesse tomada.
Este artigo explica o que é RAG e como ele funciona, sem jargão desnecessário. Mas faz, antes, a pergunta que costuma ficar de fora: a sua empresa precisa mesmo dele? Para boa parte das bases de marca — manual, catálogo, perguntas frequentes, políticas —, a resposta honesta é não.
O que é RAG em IA?
RAG é a sigla de Retrieval-Augmented Generation, em português geração aumentada por recuperação. É uma forma de montar um sistema de IA em que o modelo de linguagem não responde só com o que aprendeu no treino: antes, um mecanismo de busca procura nos seus documentos os trechos que tratam da pergunta e os coloca junto dela.
O modelo, então, redige a resposta lendo esses trechos. É a diferença entre responder de memória e responder com o documento aberto na mesa.
Duas coisas decorrem disso. A primeira: o modelo passa a falar do que é seu — preço, política de troca, especificação de produto — sem que ninguém precise retreiná-lo. A segunda: a qualidade da resposta passa a depender de a busca trazer o trecho certo. Se ela trouxer o trecho errado, o modelo responde com segurança a partir do texto errado.
Como o RAG funciona na prática?
Por dentro, um sistema de RAG tem duas etapas separadas no tempo: a preparação, que acontece uma vez (e a cada atualização da base), e a consulta, que acontece a cada pergunta.
1. Preparação: cortar e indexar
Os documentos são divididos em pedaços menores, os chunks — parágrafos ou blocos de algumas centenas de palavras. Cada pedaço é convertido num vetor numérico que representa o seu sentido (o embedding) e guardado num índice. Muitos sistemas guardam também um índice por palavra, do tipo que qualquer buscador usa.
2. Consulta: buscar, montar e responder
Quando alguém pergunta, a pergunta também vira vetor. O sistema procura no índice os pedaços mais parecidos, seleciona os primeiros colocados e monta um prompt com a pergunta e esses trechos. O modelo lê tudo e responde — de preferência indicando de qual documento tirou cada informação.
Repare que o modelo nunca vê a base inteira. Vê só o que a busca escolheu. Toda a inteligência do sistema está apoiada nessa escolha.
De onde veio o RAG?
O termo foi cunhado num artigo de 2020 liderado por Patrick Lewis, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, apresentado na conferência NeurIPS daquele ano. A proposta era combinar a memória que o modelo guarda nos próprios parâmetros com uma memória externa — no experimento, um índice da Wikipédia consultado por um buscador neural.
A ideia ganhou escala empresarial com a popularização dos assistentes de IA, quando ficou claro que o modelo sozinho não conhece o catálogo, o contrato nem a política interna de ninguém. E ganhou uma segunda motivação: naquela época, o espaço de leitura dos modelos — a janela de contexto — era pequeno demais para caber um manual inteiro.
Essa segunda motivação é justamente a que mudou. E é por isso que a pergunta "preciso de RAG?" deixou de ter resposta automática.
Qual a diferença entre RAG, fine-tuning e o próprio LLM?
Os três termos aparecem misturados, mas estão em camadas diferentes. O LLM é o modelo de linguagem — o motor que lê e escreve. RAG e fine-tuning são duas formas de fazer esse motor trabalhar com o conhecimento da sua empresa. E existe uma terceira, a mais simples, que costuma ser esquecida: colocar o conteúdo direto no prompt.
| Base inteira no prompt | RAG | Fine-tuning | |
|---|---|---|---|
| O que é | o documento vai junto com cada pergunta | uma busca escolhe trechos e os envia junto com a pergunta | o modelo é retreinado com exemplos da empresa |
| Para que serve melhor | base pequena e estável | base grande, que muda ou tem acesso restrito | tom, formato e comportamento repetitivo |
| Atualizar a informação | trocar o texto | reindexar o que mudou | treinar de novo |
| Onde costuma falhar | base que cresce além do limite | a busca não traz o trecho certo | o modelo "lembra" dado velho com confiança |
| Mostra de onde veio a resposta? | sim, se pedido no prompt | sim, é da natureza do método | não |
| Esforço de implantação | baixo | médio a alto | alto |
Comparativo da Alliance a partir de Lewis et al. (2020) e da documentação de Contextual Retrieval da Anthropic (2024)
A linha que mais importa para o dono da empresa é a de atualização. Fine-tuning ensina comportamento bem, mas é um jeito caro e lento de ensinar fatos: preço mudou, treina de novo. Por isso ele raramente é o ponto de partida de uma IA que responde sobre os documentos da empresa.
Minha empresa precisa mesmo de RAG?
Esta é a pergunta que os conteúdos de quem vende infraestrutura não fazem, e ela tem uma resposta objetiva na documentação de quem desenvolve os modelos.
Quinhentas páginas é mais do que parece. Some o manual de marca, o catálogo de produtos com descrições, as perguntas frequentes do atendimento, a política comercial e os termos de uso de uma empresa média: em muitas empresas, o total fica abaixo disso — mas só a contagem confirma.
Duas ressalvas mantêm a conta honesta. O número de 200 mil tokens é o que a Anthropic citou em 2024, para os modelos dela; outros modelos têm limites diferentes, e é preciso conferir o do que você usa. E a conversão de tokens em páginas é aproximada — o jeito certo é contar os tokens da sua base na ferramenta do próprio fornecedor, não estimar.
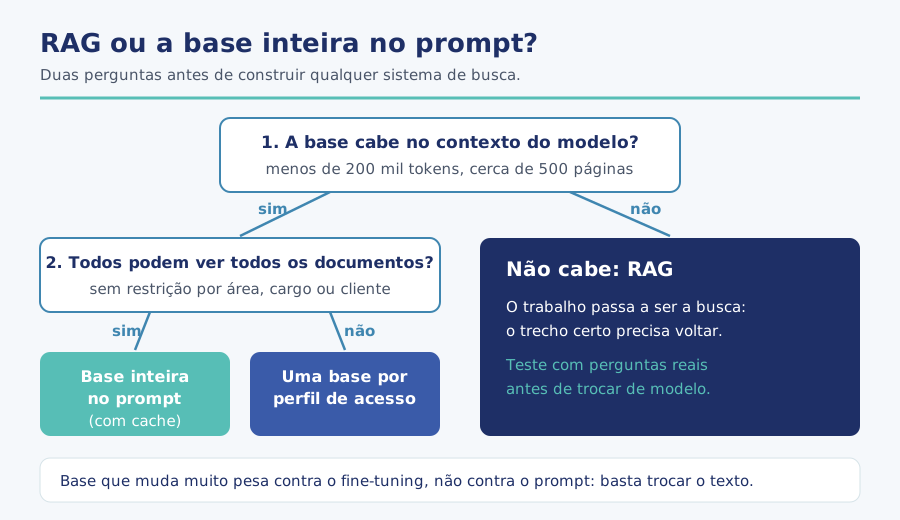
Colocar a base inteira no prompt tem um custo: cada pergunta envia o documento todo, o que pesa na conta e no tempo de resposta. É para isso que existe o cache de prompt, recurso em que o fornecedor guarda a parte repetida da mensagem e cobra menos por ela nas chamadas seguintes. No mesmo texto, a Anthropic diz que o cache de prompt torna essa abordagem bem mais rápida e barata.
Quando o RAG passa a valer a pena?
Descartar o RAG por reflexo é o erro simétrico. Há situações em que ele é a resposta certa, e elas são reconhecíveis.
1. A base não cabe no contexto
Arquivo jurídico, base de chamados de suporte acumulada em anos, documentação técnica de centenas de produtos, acervo de pesquisa. Aqui não há alternativa: o modelo precisa de uma busca que escolha o que ler.
2. Pessoas diferentes podem ver coisas diferentes
Se o contrato do cliente A não pode aparecer na resposta dada ao cliente B, ou se a política salarial é só do RH, o sistema precisa filtrar por permissão antes de montar o prompt. Com base pequena, dá para separar uma base por perfil; com base grande, esse filtro vira parte da busca. Em qualquer caso, o controle de acesso tem de ser desenhado no começo, não remendado depois — e dado pessoal na base traz as obrigações da adequação à LGPD.
3. O conteúdo muda o tempo todo
Estoque, tabela de preço, norma que sai toda semana. Numa base pequena, trocar o texto do prompt resolve. Numa grande, o RAG permite reindexar só o que mudou, sem mexer no resto.
4. É preciso provar de onde veio cada resposta
Em áreas reguladas, a resposta vale pouco sem a citação do documento e da versão. O RAG entrega isso com naturalidade, porque cada trecho recuperado carrega a sua origem.
Por que o RAG às vezes traz a resposta errada?
Quando um sistema de RAG erra, a culpa costuma cair no modelo — "a IA alucinou". Na maioria das vezes, o problema aconteceu antes: a busca não trouxe o trecho que tinha a resposta, e o modelo fez o que pôde com o que recebeu.
A causa mais comum está no corte. Um pedaço de texto separado do documento perde o contexto. A frase "a receita cresceu 3% sobre o trimestre anterior" é perfeitamente clara dentro do relatório e ambígua sozinha: receita de quem, de qual trimestre? É o exemplo que a própria Anthropic usa para explicar o problema.
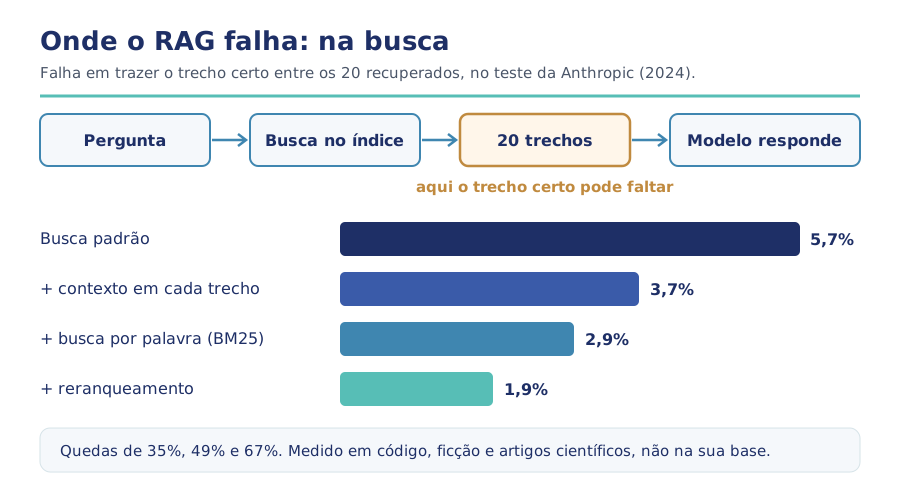
Os números têm um recorte que precisa acompanhá-los. Foram medidos pela Anthropic em bases de código, ficção e artigos científicos, com a configuração dela — não dizem quanto o RAG da sua empresa erra. O que eles mostram com clareza é outra coisa: a mesma base, com o mesmo modelo, falha três vezes menos quando a busca é bem feita.
Os nomes técnicos têm tradução simples. BM25 é a busca por palavra exata, a que acha o código de produto ou o nome próprio que a busca por sentido deixa escapar. Reranqueamento é uma segunda passada, em que um modelo relê os candidatos e reordena pela relevância real antes de entregá-los.
O que é agentic RAG, e onde entra o MCP?
No RAG clássico, a busca acontece uma vez, sempre, antes de o modelo começar a responder. No agentic RAG, o modelo decide: se precisa buscar, onde buscar, com que termos, e se o que voltou basta ou se é preciso buscar de novo. A recuperação vira uma ferramenta que o agente usa, não uma etapa fixa.
Ganha-se flexibilidade para perguntas que exigem juntar várias fontes. Perde-se previsibilidade: cada decisão a mais é um ponto a mais para testar. A lógica é a mesma que discutimos em agente de IA ou fluxo automatizado — autonomia tem custo, e só compensa onde o caminho não dá para desenhar de antemão.
O MCP entra nessa camada. Segundo a documentação oficial do Model Context Protocol, ele é um padrão aberto para conectar aplicações de IA a sistemas externos — arquivos, bancos de dados, ferramentas. Não é uma alternativa ao RAG: é o encaixe padronizado pelo qual um agente pode chegar até a sua base, seja ela consultada por RAG ou lida inteira.
Como testar se a busca está trazendo o trecho certo?
Os conteúdos mais bem colocados sobre RAG em português não ensinam a testá-lo — e é o teste que separa um sistema confiável de uma demonstração bonita. O método não exige ferramenta sofisticada.
- Junte de 30 a 50 perguntas reais: do atendimento, do comercial, do WhatsApp. Pergunta inventada pelo time técnico é fácil demais.
- Para cada pergunta, anote qual documento e qual trecho contêm a resposta certa. É o seu gabarito.
- Rode as perguntas e olhe só a busca, antes da resposta: o trecho do gabarito está entre os recuperados?
- Conte quantas vezes não está. Essa é a sua taxa de falha de recuperação — a mesma métrica do estudo da Anthropic.
- Mude uma coisa por vez (tamanho do corte, contexto por trecho, busca por palavra, reranqueamento) e rode de novo o mesmo gabarito.
Só depois de a busca passar faz sentido avaliar a redação da resposta. Trocar de modelo para consertar uma busca ruim é o jeito mais caro de não resolver nada.
Quais erros mais aparecem na implantação?
- Construir RAG para uma base de 60 páginas que caberia inteira no prompt, pagando em complexidade o que não precisava.
- Jogar na base tudo o que existe — versões antigas, rascunhos, propostas vencidas — e esperar que a busca saiba qual vale.
- Cortar os documentos em tamanho fixo sem olhar a estrutura, separando a pergunta da resposta numa FAQ ou a tabela do seu título.
- Desenhar o controle de acesso depois, quando o sistema já respondeu a quem não devia.
- Avaliar só a resposta final, sem medir a busca, e culpar o modelo por um trecho que nunca chegou até ele.
- Não nomear um responsável pela base: o sistema fica certo no lançamento e errado três meses depois.
Os dois primeiros erros têm a mesma raiz: tratar o problema como técnico quando ele é editorial. Uma base enxuta, sem duplicidade e com uma versão oficial de cada informação resolve mais do que qualquer ajuste de arquitetura.
O que muda conforme o tipo de base?
| Tipo de base | Caminho provável | O cuidado que decide |
|---|---|---|
| Manual de marca, tom de voz e FAQ | base inteira no prompt | uma versão oficial de cada resposta |
| Catálogo de algumas centenas de itens | prompt inteiro ou RAG, conforme o tamanho | conferir a contagem de tokens, não estimar |
| Tabela de preço e estoque | consulta direta ao sistema de origem | não copiar número que muda para dentro de texto |
| Contratos e dados de clientes | RAG com filtro de permissão | acesso desenhado antes da primeira resposta |
| Acervo técnico ou jurídico extenso | RAG com busca híbrida e reranqueamento | gabarito de perguntas para medir a busca |
Leitura da Alliance a partir da documentação da Anthropic sobre Contextual Retrieval (2024)
A terceira linha merece atenção: preço e estoque raramente deveriam estar num texto indexado. Eles mudam mais rápido do que qualquer índice, e o caminho certo é o agente consultar o sistema que já tem o número atualizado — por integração ou por MCP.
Por onde começar hoje
- Liste os documentos que a IA precisaria consultar e descarte o que está vencido ou duplicado.
- Conte os tokens do que sobrou. Se couber no contexto do modelo que você usa, comece pela base inteira no prompt, com cache.
- Mapeie quem pode ver o quê. Se houver restrição, separe as bases por perfil ou desenhe o filtro antes de qualquer outra coisa.
- Monte o gabarito de 30 a 50 perguntas reais — ele serve para qualquer caminho, com ou sem RAG.
- Só parta para RAG se a base não couber, e meça a busca antes de avaliar a resposta.
- Nomeie um dono para a base. Informação desatualizada é o erro que nenhuma técnica de busca corrige.
O trabalho que mais pesa no resultado não é escolher banco vetorial: é ter uma base de conhecimento enxuta, correta e com dono. É isso que fazemos na base de conhecimento de marca para IA — a mesma base que alimenta os seus agentes e a camada que as IAs de fora leem, tema do nosso artigo sobre para que serve o llms.txt. E se a dúvida ainda é em que ponto a sua operação está, o diagnóstico gratuito de marketing mede a maturidade em tecnologia e dados junto com as outras áreas. Do diagnóstico à ação.