A cena se repete em muita empresa que começou a usar IA no dia a dia. Alguém cola o manual da marca no começo da conversa, pede um texto, e o primeiro sai certo. Na sétima ou oitava mensagem, aparece a palavra que o manual proíbe, o tom escorrega para o genérico e a política de troca vira outra. A conclusão comum é que “a IA esqueceu”, e a solução proposta costuma ser trocar de ferramenta ou pagar por uma janela maior.
Este artigo explica o que é a janela de contexto, o que ocupa espaço dentro dela e o que acontece quando ela enche. Mas vai além da tabela de tamanhos que se encontra em todo lugar: mostra por que um manual que cabe inteiro na janela ainda pode ser lido pela metade, e como reescrever a base da marca para que a IA continue obedecendo na décima mensagem, não só na primeira.
O que é janela de contexto na IA?
Janela de contexto é o espaço de texto que um modelo de linguagem (LLM) consegue enxergar no momento em que escreve uma resposta. Tudo o que está dentro dela pode ser consultado; o que está fora, para aquele modelo, não existe naquela hora.
A documentação da Anthropic sobre janelas de contexto define o conceito como todo o texto que o modelo pode consultar ao gerar uma resposta, incluindo a própria resposta, e o compara a uma memória de trabalho, diferente do grande volume de dados usado no treino. A comparação ajuda: é a mesa de trabalho, não a biblioteca.
Na prática, para quem usa IA em marketing e atendimento, a janela é onde mora tudo o que é seu: o manual de marca colado no início, o catálogo anexado, o histórico do atendimento, as instruções do assistente. O modelo não “sabe” nada disso por conta própria. Ele lê, a cada resposta, o que estiver na mesa.
O que ocupa espaço na janela, e o que é um token?
A janela não é medida em páginas nem em palavras, e sim em tokens. Segundo o glossário da Anthropic, token é a menor unidade com que o modelo trabalha, e pode corresponder a uma palavra, a um pedaço de palavra, a um caractere ou até a um byte. Quantos caracteres cabem em cada token depende do modelo e do idioma, e por isso não existe conversão fixa de token para página que sirva para todos.
O ponto que mais surpreende quem gerencia conteúdo é o que entra na conta. Pela documentação da Anthropic, contam para a janela:
- as instruções fixas do assistente (o chamado prompt de sistema);
- cada mensagem da conversa, incluindo documentos, imagens e resultados de ferramentas;
- as definições das ferramentas que o assistente pode usar;
- a resposta que o modelo está gerando naquele turno, inclusive o raciocínio estendido, quando ele está ligado.
E há um detalhe que explica boa parte do “esquecimento”: cada turno se acumula. A pergunta da décima mensagem chega ao modelo junto com as nove perguntas e as nove respostas anteriores. O manual colado lá no começo continua na mesa, mas agora disputa atenção com tudo o que veio depois dele.
Qual a diferença entre janela de contexto, memória e treino?
Os três termos aparecem misturados em conversa de fornecedor, e a confusão leva a decisões erradas, como achar que basta “ensinar” a marca uma vez para a IA lembrar para sempre.
| Dados de treino | Janela de contexto | Memória e base externa | |
|---|---|---|---|
| O que é | o que o modelo aprendeu antes de chegar até você | o texto que ele lê agora, nesta conversa | anotações e documentos guardados fora, trazidos quando necessário |
| Contém a sua marca? | em geral, não, ou só o que é público | só se você colocar | só o que você cadastrar |
| Quanto dura | até a próxima versão do modelo | a conversa, e às vezes nem ela inteira | até alguém apagar ou atualizar |
| Quem controla | o fornecedor do modelo | quem monta o prompt e conversa | quem administra a base |
| Erro típico | dado velho dito com segurança | regra ignorada no meio de um texto longo | documento desatualizado buscado como verdade |
Comparativo da Alliance a partir da documentação de janelas de contexto e do guia de engenharia de contexto da Anthropic
A linha que importa para quem cuida da marca é a de controle. O treino não está nas suas mãos. A janela e a base externa estão, e é nelas que o trabalho de conteúdo faz diferença. Quando a base cresce além do que cabe na mesa, entra a busca em documentos, o RAG, assunto que tratamos em o que é RAG e quando a empresa nem precisa dele.
O que acontece quando a janela de contexto enche?
Depende de onde você usa a IA, e é aqui que o manual colado no início corre o maior risco.
Em interfaces de chat, a documentação da Anthropic registra que produtos como o claude.ai podem administrar a janela no esquema “primeiro a entrar, primeiro a sair”. Leia de novo pensando no manual: se a conversa cresce demais, o primeiro conteúdo a sair da mesa é justamente o que foi colado primeiro.
Em integrações pela API, aquelas que alimentam um chatbot ou um fluxo automatizado, a mesma documentação descreve que, nos modelos mais recentes, a geração para quando atinge o limite da janela e informa o motivo da parada; em modelos anteriores, a requisição era recusada com erro. Em nenhum dos casos o sistema decide sozinho o que da sua marca é mais importante.
A saída mais usada para conversas longas é a compactação: quando a conversa se aproxima do limite, o conteúdo é resumido e uma nova janela começa a partir do resumo. A Anthropic a descreve, no guia de engenharia de contexto, como a primeira alavanca para manter a coerência em tarefas longas. O risco para a marca é óbvio: resumo é escolha, e uma regra escrita de forma vaga pode não sobreviver a ele.
Se o manual cabe na janela, por que a IA esquece a regra?
Esta é a pergunta que os conteúdos sobre janela de contexto costumam pular. Eles explicam o esquecimento só como estouro: a conversa passou do limite e o começo caiu. Só que a maior parte dos manuais de marca cabe com folga nas janelas atuais, e mesmo assim a regra se perde.
O guia de engenharia de contexto da empresa explica a razão com uma imagem útil: o modelo tem um orçamento de atenção, e cada token novo consome um pedaço dele. Por isso a orientação não é encher a janela, e sim buscar o menor conjunto possível de informação de alto sinal que aumente a chance do resultado desejado.
Traduzido para o manual da marca: cada página de história, de manifesto, de case antigo e de anexo repetido compete com a regra que importa. O manual não precisa estourar a janela para a regra perder a disputa. Basta estar diluída.
Caber na janela não é ser lido. Uma regra pode estar dentro do contexto e, ainda assim, perder a disputa pela atenção do modelo.
Por que o meio do documento é o lugar mais perigoso?
Além da quantidade, a posição pesa. O estudo mais citado sobre isso foi publicado em 2023 por pesquisadores liderados por Nelson F. Liu, e testou modelos em tarefas em que a informação útil estava escondida em pontos diferentes de um contexto longo.
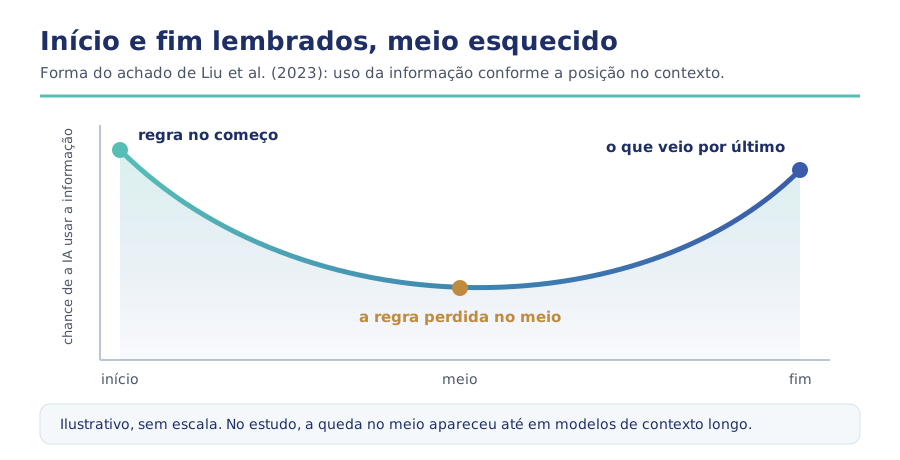
Agora pense na ordem clássica de um manual de marca: história, manifesto, missão e valores, logotipo, cores, tipografia, aplicações. O tom de voz e as palavras proibidas costumam vir depois de tudo isso. Os preços e as exceções de política, quando aparecem, estão num anexo. As regras que mais importam para um texto ficam exatamente na zona em que o modelo presta menos atenção.
E há um agravante na conversa longa. A cada mensagem, o manual colado no início vai sendo empurrado do “fim recente” para uma posição cada vez mais distante, enquanto o que domina a parte final da janela são as últimas trocas. Não é a IA que fica desatenta com o tempo: é o manual que vai mudando de lugar dentro da mesa.
Janela maior resolve? O que muda com 1 milhão de tokens
Janelas cresceram muito, e a documentação da Anthropic já fala em até 1 milhão de tokens, dependendo do modelo. É espaço suficiente para colocar uma base de conhecimento inteira na conversa. A mesma empresa, num artigo sobre recuperação de contexto, já afirmava que uma base com menos de 200 mil tokens, cerca de 500 páginas, pode ir inteira no prompt, sem busca em documentos.
Isso resolve o problema de caber. Não resolve o de ser lido. A frase sobre context rot está na mesma página que anuncia as janelas grandes, e não por acaso: mais espaço permite colocar mais coisa, e mais coisa dilui a regra. Uma janela de 1 milhão de tokens cheia de material irrelevante é uma mesa enorme, coberta de papel, com o bilhete importante embaixo da pilha.
A decisão sensata, então, não é escolher o modelo pela maior janela. É escolher pelo trabalho e, ao mesmo tempo, reduzir e ordenar o que entra nela. Para conferir o tamanho atual da janela de qualquer modelo, vale sempre a página oficial do fornecedor: esse número muda a cada lançamento, e tabela copiada de blog envelhece rápido.
Como reorganizar o manual da marca para a janela de contexto
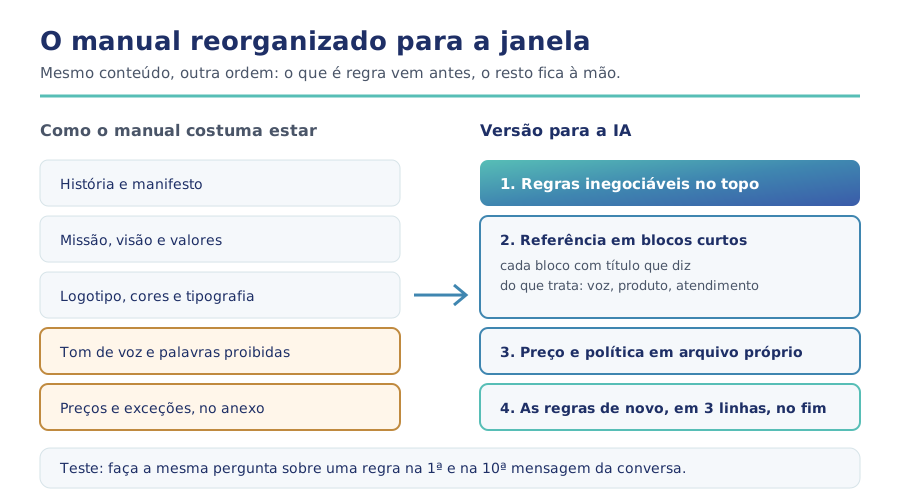
O conteúdo do manual não precisa mudar. A ordem e o formato, sim. O objetivo é que a regra esteja no lugar onde o modelo presta mais atenção e que nada irrelevante dispute com ela. Para quem já mantém uma base de artigos de atendimento, o raciocínio é o mesmo que explicamos em como escrever o artigo que a IA lê sozinha.
1. Separe o que é regra do que é referência
Leia o manual com uma pergunta: “se a IA ignorar isto, alguém reclama?”. Palavra proibida, promessa que a empresa não pode fazer, tratamento do cliente, nome correto dos produtos, o que nunca dizer sobre concorrente. Isso é regra. História da fundação, manifesto e explicação do logotipo são referência: úteis, mas não mudam o texto de hoje.
2. Coloque as regras no topo, curtas e verificáveis
As regras abrem o documento, em lista, uma por linha, escritas de modo que dê para conferir se foram cumpridas. “Seja próximo” não se verifica; “trate o cliente por você, nunca por senhor ou senhora” se verifica. O guia da Anthropic pede linguagem simples e direta e alerta para os dois extremos: a lógica rígida demais e a orientação vaga demais. O guia de tom de voz escrito para a IA detalha esse ponto.
3. Quebre a referência em blocos curtos com título claro
Depois das regras, a referência vem em seções pequenas, cada uma com um título que diga do que trata: voz, produtos, atendimento, temas sensíveis. Título claro ajuda o modelo a localizar o trecho e ajuda a equipe a manter o documento. Bloco de dez páginas sem subtítulo é o meio perigoso do estudo, em versão ampliada.
4. Tire da janela o que muda sempre
Preço, prazo, estoque e política comercial mudam mais do que a identidade. Vão para documentos próprios, curtos e datados, carregados só quando a conversa pede. A Anthropic descreve essa lógica como contexto “na hora certa”: em vez de carregar tudo antes, o sistema guarda referências leves e traz o dado quando precisa. Para a marca, isso significa um manual que não envelhece a cada reajuste.
5. Repita as regras em poucas linhas no fim
Se o começo e o fim são as posições mais lidas, use as duas. Feche o documento com as regras resumidas em três ou quatro linhas. Não é redundância desleixada: é colocar o que importa nos dois pontos de maior atenção, sabendo que o miolo é o que mais se perde.
6. Em conversa longa, recomece com um resumo
Para trabalho extenso, em vez de esticar a mesma conversa por dezenas de mensagens, abra uma nova com o manual enxuto e um resumo do que já foi decidido. É a compactação feita à mão, com a vantagem de que é você, e não o sistema, quem escolhe o que fica.
Como testar se a IA ainda obedece na décima mensagem?
Reorganizar sem testar é trocar uma suposição por outra. O teste é simples e pode ser feito por quem cuida do conteúdo, sem ferramenta técnica.
- Escolha de três a cinco regras do manual que sejam fáceis de conferir: uma palavra proibida, um tratamento, um nome de produto, uma promessa vetada.
- Para cada uma, escreva um pedido que tente a IA a quebrá-la, como pedir um texto “bem vendedor” quando a regra veta promessa de resultado.
- Abra uma conversa com o manual e faça esses pedidos logo nas primeiras mensagens. Anote se cada regra foi cumprida.
- Na mesma conversa, faça outros pedidos comuns do dia a dia até passar da décima mensagem. Depois, repita os pedidos que testam as regras.
- Compare as duas rodadas. A regra que passa no começo e cai no fim está no lugar errado do documento ou escrita de forma vaga.
- Reorganize o manual pelos passos acima e rode o mesmo roteiro de novo, com os mesmos pedidos, para comparar de forma justa.
Guarde o roteiro. Ele serve de régua sempre que o manual mudar, o fornecedor trocar de modelo ou alguém da equipe sugerir colar “só mais um documento” na conversa. Quando a IA erra fatos sobre a empresa, e não só o tom, o problema muda de natureza: vale ler o que explicamos sobre alucinação de IA e o bot que inventa sobre a marca.
Quais erros mais aparecem quando a marca entrega o manual à IA?
- Colar o PDF inteiro, do jeito que foi feito para impressão. Capa, sumário, páginas de imagem e créditos ocupam espaço e não acrescentam regra nenhuma.
- Juntar todas as versões do manual “por garantia”. Duas versões com regras diferentes na mesma janela obrigam o modelo a escolher, e ele pode escolher a antiga.
- Escrever regra como valor. “Somos inovadores” não orienta texto. “Não use a palavra revolucionário” orienta.
- Medir pela primeira resposta. A primeira resposta quase sempre sai boa. O problema aparece depois, e só o teste na conversa longa mostra.
- Trocar de modelo esperando que a janela maior resolva. Sem reorganizar o documento, o mesmo manual diluído se perde numa mesa maior.
- Esquecer de atualizar. Manual parado com preço velho é pior que nenhum: a IA repete o erro com a segurança de quem leu a fonte oficial.
O que muda conforme o uso da IA na empresa?
A regra geral vale para todos os casos, mas o ponto de atenção muda conforme quem conversa com a IA e por quanto tempo.
| Uso | Onde o manual se perde | O que fazer primeiro |
|---|---|---|
| Equipe escrevendo com IA no chat | conversas longas, com o manual colado só no início | projeto ou instrução fixa com o manual enxuto, e conversa nova por tarefa |
| Chatbot de atendimento | histórico do cliente e respostas de ferramentas empurram as regras para o meio | regras curtas nas instruções fixas e política em documento separado |
| Agente que executa tarefas em várias etapas | resultados de ferramentas enchem a janela rápido | compactação planejada e referências carregadas só quando necessárias |
| Geração de conteúdo em volume | o mesmo manual longo repetido em cada pedido | versão mínima com regras e exemplos, testada antes de escalar |
| Base de conhecimento grande | o documento certo não chega à janela | organizar a base e, se ela não couber, avaliar busca em documentos |
Comparativo da Alliance com base no guia de engenharia de contexto da Anthropic
Em todos os casos, o trabalho de fundo é o mesmo: decidir o que é regra, escrever de forma verificável e manter atualizado. É um trabalho de conteúdo, não de tecnologia, e por isso costuma ficar sem dono entre o marketing e a TI.
Por onde começar hoje
Comece pequeno. Pegue o manual atual, separe as regras do resto e escreva uma página só com elas, no topo. Rode o teste da décima mensagem com a versão antiga e com a nova, usando os mesmos pedidos, e veja o que muda. Só depois pense em ferramenta, modelo ou tamanho de janela.
Se a sua empresa já usa IA no atendimento ou na produção de conteúdo e quer uma base de marca escrita para ser lida por gente e por máquina, esse é o trabalho do nosso serviço de Base de Conhecimento da Marca. E se ainda não está claro onde a comunicação da empresa perde força, o diagnóstico de marketing gratuito da Alliance mostra em que ponto vale começar.