A empresa atualizou a tabela de preços em janeiro, subiu o PDF novo para o assistente de atendimento e deu o assunto por resolvido. Em março, um cliente reclama: o robô informou o valor do ano passado. Ninguém mexeu no robô. O PDF antigo nunca saiu de onde estava.
Esse é o problema que quase nenhum texto sobre banco de dados vetorial menciona. Os guias explicam bem como os vetores são comparados e quais algoritmos aceleram a busca. Este artigo cobre o básico, mas foca no que decide se a resposta da IA vai estar certa: o ciclo de vida do conteúdo dentro do índice.
O que é um banco de dados vetorial?
Um banco de dados vetorial guarda vetores — listas de números que representam o sentido de um trecho de texto, de uma imagem ou de um áudio — e responde a uma pergunta só: quais itens guardados estão mais perto deste aqui? Em vez de procurar a palavra exata, ele procura proximidade de significado.
No contexto de IA, é a peça que dá memória consultável a um assistente. Os manuais, as fichas de produto e as políticas da empresa são cortados em trechos, cada trecho vira um vetor, e o banco devolve os mais parecidos com o que o cliente perguntou. Como esses vetores são gerados está explicado em embeddings: por que a IA confunde dois produtos da marca; aqui o assunto é o lugar onde eles ficam.
Um aviso de vocabulário, porque o termo tem dois sentidos. Em geoprocessamento, "dado vetorial" é ponto, linha e polígono num mapa, e há banco de dados espacial feito para isso. Quem chegou aqui procurando mapas está no artigo errado: o banco vetorial de que tratamos é o da inteligência artificial.
Qual a diferença entre banco de dados vetorial e banco de dados relacional?
O banco relacional, o de tabelas e linhas, responde perguntas exatas: qual o preço do produto de código 4512, quantos pedidos entraram ontem. O banco vetorial responde perguntas aproximadas: qual trecho fala de algo parecido com "posso devolver depois de usar?". Um não substitui o outro.
| Banco relacional | Banco de dados vetorial | |
|---|---|---|
| O que guarda | Linhas e colunas com valores definidos | Vetores numéricos, com o texto e os metadados ao lado |
| Tipo de pergunta | Exata: igual, maior que, contém | Aproximada: o mais parecido com isto |
| Resultado | Todos os registros que atendem à condição | Os N vizinhos mais próximos, em ordem de semelhança |
| Quando erra | Quando o dado está errado na tabela | Quando o trecho parecido não é o trecho certo, ou está vencido |
| Atualizar um valor | Um UPDATE troca o valor no lugar | O conteúdo novo entra como item novo; o antigo precisa ser removido |
Comparativo elaborado pela Alliance Comunicação.
A última linha da tabela é a que interessa a quem cuida de marca. No banco relacional, corrigir o preço apaga o preço velho. No vetorial, o trecho antigo é um item independente, com vetor próprio, e convive com o novo até ser retirado.
Como funciona um banco de dados vetorial por dentro?
São dois momentos. Na entrada, o documento é dividido em fatias (os chunks), cada fatia passa por um modelo de embedding e o vetor resultante é gravado junto com o texto original e com atributos, como nome do arquivo, data e categoria. Na consulta, a pergunta do usuário também vira vetor e o banco devolve as fatias mais próximas.
Comparar a pergunta com cada vetor guardado, um por um, seria lento numa base grande. Por isso os bancos usam índices de vizinho aproximado, dos quais o HNSW é o mais citado: em vez de olhar tudo, o índice percorre um grafo de vizinhos e chega a um resultado muito bom em muito menos tempo, abrindo mão da garantia de achar o melhor absoluto.
O fatiamento merece atenção, porque define o que exatamente vai ser recuperado. Os provedores escolhem um padrão, e ele raramente é visível para quem só sobe os arquivos:
Com 400 tokens de sobreposição sobre fatias de 800, cada fatia repete metade da anterior. A consequência prática é aritmética: quase toda frase do documento existe em duas fatias. A linha com o preço antigo não é um vetor no índice, são dois, e qualquer um deles pode ser o escolhido.
Por que o documento antigo continua respondendo?
Porque o banco vetorial mede semelhança, não validade. A tabela de 2025 e a de 2026 falam do mesmo assunto, com as mesmas palavras, na mesma estrutura. Para o índice, as duas são respostas igualmente boas para "quanto custa o plano?" — e a de 2025 pode até ganhar, se estiver escrita de um jeito mais próximo da pergunta.
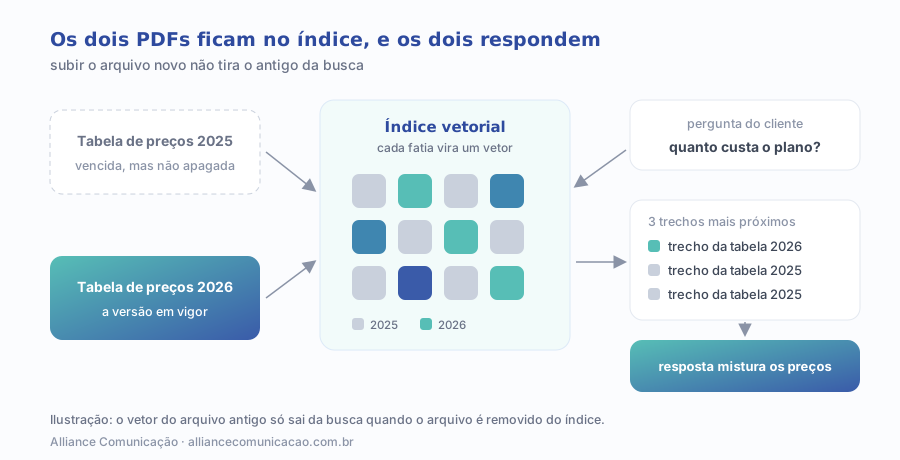
Três situações produzem o documento fantasma. A primeira é a substituição feita na pasta, não no índice: o arquivo novo é enviado, o antigo é apagado do drive da equipe, mas o vector store tem a sua própria cópia. A segunda é a duplicação: a mesma política entra em três PDFs diferentes (o manual, a apresentação comercial e o FAQ), e só um é corrigido. A terceira é o conteúdo temporário que nunca expira, como a campanha de Black Friday que segue respondendo em março.
E mesmo a remoção correta não é instantânea. A documentação da OpenAI avisa que tirar um arquivo do vector store é uma operação de consistência eventual: por um curto período, a busca ainda pode trazer conteúdo do arquivo removido. Em mudança sensível, como preço, convém remover antes de anunciar, não depois.
Para o índice, um documento vencido não é um documento errado. É só mais um documento parecido com a pergunta.
Banco de dados vetorial é a mesma coisa que RAG?
Não. RAG é a arquitetura inteira: buscar trechos relevantes e entregá-los ao modelo de linguagem para que ele redija a resposta. O banco vetorial é uma das peças dessa arquitetura, a que guarda e encontra os trechos. Dá para fazer RAG com busca por palavra-chave, sem banco vetorial, e dá para usar banco vetorial sem RAG, em recomendação de produtos ou deduplicação de cadastros.
A pergunta anterior, se a empresa precisa mesmo de RAG, tem resposta própria em RAG em IA: quando a empresa nem precisa dele. Muitas bases de marca cabem inteiras no contexto do modelo e dispensam índice. Quem passou desse ponto e já tem um banco vetorial ganhou, junto, a tarefa de mantê-lo limpo.
Quanto custa guardar documentos num banco de dados vetorial?
Gerar os vetores é barato; guardar tem custo contínuo, e é aí que o arquivo esquecido começa a pesar no bolso além de pesar na resposta. Nos serviços gerenciados, a cobrança costuma ser por volume armazenado ao longo do tempo. A OpenAI publica a sua conta:
Uma conta de exemplo, só para dar escala: se o armazenamento somar 3 GB, os 2 GB acima da faixa gratuita custam US$ 0,20 por dia, cerca de US$ 6 em 30 dias. É pouco para uma empresa, mas é custo que cresce sozinho quando cada versão nova entra e nenhuma antiga sai. A base que só acumula paga para guardar o conteúdo que atrapalha.
Em banco próprio, como o PostgreSQL com a extensão pgvector, não há tarifa por GB do fornecedor, mas há servidor, disco, backup e alguém para cuidar. Na leitura da Alliance, para a maioria das bases de marca o custo do banco é a menor parte da conta: o que pesa são as horas de quem prepara, revisa e retira conteúdo.
Como governar o ciclo de vida do conteúdo no índice?
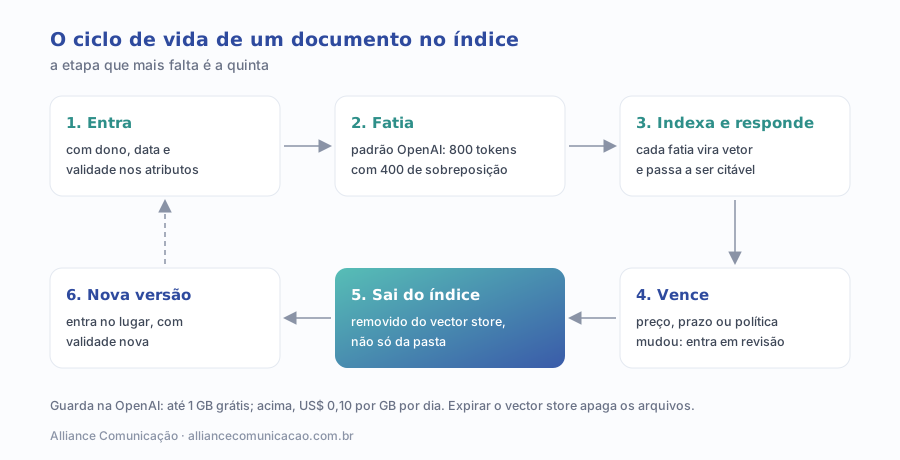
Governar é tratar cada documento como algo que nasce, responde, vence e sai. O diagrama resume as seis etapas; as práticas abaixo dizem como fazer cada uma sem depender da memória de ninguém.
1. Dono, data e validade em cada arquivo
Todo arquivo entra com três informações: quem responde por ele, quando foi aprovado e até quando vale. No vector store da OpenAI, cada arquivo aceita atributos, um dicionário de até 16 chaves, que podem ser usados na busca. Validade escrita só dentro do PDF não serve: a máquina não lê o rodapé como regra.
2. Uma fonte por assunto
Se a política de troca aparece no manual, na apresentação e no FAQ, ela vai ser corrigida em um lugar e esquecida nos outros dois. Escolha a fonte oficial de cada assunto e deixe as outras peças fora do índice, ou com o trecho removido. Duplicação é a causa mais silenciosa de resposta contraditória.
3. Substituir é remover e incluir
Trocar a versão de um documento são duas operações, não uma: remover o arquivo antigo do vector store e incluir o novo. Na documentação da OpenAI, atualizar um arquivo do vector store aparece como mudança de atributos; o texto novo entra como arquivo novo. Apagar o PDF da pasta compartilhada não toca no índice.
4. Filtro por validade na consulta
Enquanto a remoção não acontece, um filtro protege a resposta. A busca do vector store aceita filtros por atributo com comparações como igual, diferente, maior e menor; com um campo de validade numérico, a consulta pode ignorar o que já venceu. É uma rede de segurança, não substituto da limpeza.
5. Expiração para o que é temporário
Campanha, promoção e evento têm data de fim conhecida no dia em que entram. Coloque esse conteúdo num vector store separado com política de expiração: quando ele expira, os arquivos são apagados e saem da cobrança. O que é temporário não deveria depender de alguém lembrar de tirar.
6. Registro do que entrou e do que saiu
Uma planilha simples resolve: arquivo, versão, data de entrada, data de saída, motivo. Quando o atendimento questionar uma resposta, o registro diz em minutos se o trecho citado estava vigente. Sem ele, a investigação começa do zero toda vez.
A forma de escrever cada artigo para que a IA o leia bem — um assunto por artigo, resposta no primeiro parágrafo, termos fixos — está em base de conhecimento: como escrever o artigo que a IA lê sozinha. As práticas acima cuidam do outro lado: o que acontece com esse artigo depois que ele entra no índice.
Qual banco de dados vetorial escolher?
Não existe o melhor banco de dados vetorial em abstrato; existe o que cabe na equipe e no volume. Para uma base de marca, com centenas ou poucos milhares de documentos, as três famílias resolvem a busca. O que muda é quem opera e quanto controle se tem sobre o ciclo de vida.
| Opção | Quando faz sentido | O que exige |
|---|---|---|
| Vector store gerenciado do provedor de IA (ex.: OpenAI) | Assistente que já usa a API do provedor e base de tamanho moderado | Rotina de remover arquivos e cuidar dos atributos; custo por GB acima da faixa gratuita |
| Extensão no banco que a empresa já tem (ex.: pgvector no PostgreSQL) | Equipe que já opera PostgreSQL e quer os vetores ao lado dos dados do negócio | Servidor, backup e manutenção do índice; remoção é um DELETE comum |
| Banco vetorial dedicado (ex.: Pinecone, Qdrant, Milvus, Weaviate, Chroma) | Volume grande, muitas coleções ou exigência de desempenho específica | Mais uma peça de infraestrutura para contratar ou operar |
Comparativo elaborado pela Alliance Comunicação.
Sobre o PostgreSQL: dá, sim, para usá-lo como banco de dados vetorial. O pgvector, extensão de código aberto, acrescenta um tipo de dado vetorial, distâncias como cosseno e produto interno, e índices HNSW e IVFFlat, a partir do Postgres 13. A própria documentação lembra que a limpeza do índice HNSW após remoções (o VACUUM) pode demorar, e sugere reindexar antes — mais um sinal de que apagar também é trabalho de operação.
Quais os erros mais comuns com banco de dados vetorial?
- Tratar a pasta compartilhada como se fosse o índice. Apagar ou renomear o arquivo no drive não muda nada no vector store. São dois lugares, com duas cópias.
- Subir a versão nova sem tirar a antiga. É o erro deste artigo e o mais frequente: as duas convivem, e a busca escolhe pela semelhança, não pela data.
- Indexar tudo o que existe. Apresentações antigas, rascunhos e propostas de clientes entram "por via das dúvidas" e viram fonte citável. O que não deve responder não deve entrar.
- Não saber qual fatiamento está valendo. Fatia grande mistura assuntos; fatia pequena perde contexto. Quem nunca olhou o padrão do provedor não sabe o que o robô está lendo.
- Escolher o banco antes de decidir o conteúdo. A discussão sobre fornecedor consome semanas; a lista de quais documentos são oficiais, que resolve metade dos problemas, nunca é feita.
- Esquecer o conteúdo com prazo. Promoção sem data de saída no índice continua sendo oferecida depois de acabar, e o cliente cobra.
Como medir se o índice está limpo?
Medição de banco vetorial costuma olhar velocidade e precisão da busca. Para a marca, a métrica que importa é outra: com que frequência a IA responde com conteúdo vencido. Ela se mede com um conjunto fixo de perguntas e uma auditoria periódica do que está guardado.
- Monte uma lista de 20 a 30 perguntas sobre o que muda com frequência: preço, prazo, política de troca, condições comerciais, produtos descontinuados.
- Depois de cada mudança, rode as perguntas e anote de qual arquivo veio cada trecho citado. Resposta certa vinda do arquivo errado também é falha.
- Uma vez por mês, liste os arquivos do índice e cruze com o registro: tudo o que passou da validade ou não tem dono vai para revisão.
- Acompanhe o volume armazenado. Base que só cresce, mês a mês, é sinal de que nada está saindo.
O que muda conforme o tipo de base?
Nem toda base envelhece no mesmo ritmo. A frequência de revisão e o rigor da remoção acompanham a velocidade com que o conteúdo muda e o estrago que uma resposta antiga causa:
- Catálogo e preços: muda muito e o erro custa dinheiro. Remoção no mesmo dia da mudança e filtro de validade obrigatório.
- Políticas e termos: muda pouco, mas o erro tem peso jurídico. Uma única fonte oficial e registro de versão com data.
- Manual de marca e tom de voz: muda raramente. Revisão anual e cuidado para que versões antigas do manual não fiquem indexadas.
- Campanhas e promoções: já nasce com data de fim. Vector store separado, com expiração.
Por onde começar hoje?
Quem já tem um assistente com base própria não precisa trocar de banco para melhorar a resposta. Precisa saber o que está lá dentro. A sequência curta:
- Liste todos os arquivos que estão hoje no índice, não na pasta da equipe.
- Marque cada um como vigente, vencido ou duplicado, e dê um dono a cada vigente.
- Remova do índice os vencidos e os duplicados, e acrescente data e validade como atributo nos que ficam.
- Separe o que é temporário num vector store com expiração.
- Rode as perguntas de teste e repita a auditoria todo mês.
Para quem ainda vai montar a base, a Base de Conhecimento de Marca para IA da Alliance organiza o conteúdo oficial, define donos e validades e entrega a rotina de entrada e saída junto com o índice. E se a dúvida ainda é onde a IA entra no marketing da empresa, o diagnóstico de marketing gratuito leva cerca de 30 minutos e aponta as prioridades por área.