Uma empresa monta um assistente com a base de conhecimento da marca. Um cliente pergunta a garantia da linha Pro, e o assistente responde, com toda a segurança, a garantia da linha Plus. Ninguém programou o erro. Ele nasceu de um mecanismo que quase toda IA com base própria usa por baixo: os embeddings.
Este guia explica o que são embeddings, como eles transformam texto em números, quanto custa gerá-los e qual modelo escolher. E entra no ponto que os verbetes deixam de fora: o embedding mede proximidade de sentido, não verdade — e a forma como a base da marca é escrita decide se o assistente acha o trecho certo ou o vizinho.
O que é um embedding?
Embedding é a representação de um conteúdo — uma palavra, uma frase, um parágrafo, uma imagem — como uma lista de números. Cada número é uma coordenada, e o conjunto delas posiciona o conteúdo num espaço com centenas ou milhares de dimensões. Conteúdos de sentido parecido ficam perto; conteúdos sem relação ficam longe.
O valor disso para uma empresa é simples de enxergar. Uma busca por palavra-chave só acha "prazo de troca" se o texto disser "prazo de troca". Uma busca por embedding acha também o parágrafo que fala em "devolução em até 30 dias", porque os dois trechos ficam próximos no espaço de sentido, mesmo sem palavra em comum.
Na prática, ninguém olha para os números. O que se vê é o efeito: o assistente que entende a pergunta escrita de qualquer jeito, a recomendação de conteúdo relacionado, o agrupamento automático de chamados de atendimento parecidos.
De onde vêm os embeddings?
A ideia de representar palavras como vetores é antiga na linguística computacional, mas ganhou escala com o Word2Vec, apresentado em 2013 por Tomas Mikolov, Kai Chen, Greg Corrado e Jeffrey Dean, do Google, no artigo "Efficient Estimation of Word Representations in Vector Space". O trabalho mostrou como gerar vetores de palavras a partir de volumes muito grandes de texto com custo computacional menor que as técnicas anteriores.
Esses são os word embeddings: um vetor por palavra. O salto seguinte foi gerar um vetor para um trecho inteiro, considerando o contexto — a palavra "manga" deixa de ter um só vetor e passa a significar fruta ou parte da camisa conforme a frase. É esse tipo de embedding, de frase e de parágrafo, que move a busca nas bases de conhecimento de hoje.
Qual a diferença entre embedding, banco de dados vetorial e RAG?
Os três aparecem juntos e costumam ser confundidos. São camadas diferentes do mesmo sistema:
| O que é | Pergunta que responde | |
|---|---|---|
| Embedding | O vetor numérico de um trecho | Onde este conteúdo fica no espaço de sentido? |
| Modelo de embedding | O programa que gera os vetores | Como transformo texto em números? |
| Banco de dados vetorial | Onde os vetores ficam guardados e são comparados | Quais trechos estão mais perto desta pergunta? |
| Busca semântica | A consulta por proximidade de sentido | Qual trecho fala do mesmo assunto? |
| RAG | A arquitetura que busca trechos e entrega ao modelo de linguagem | Como a IA responde com a base da empresa? |
Elaborado pela Alliance Comunicação.
O embedding é o mecanismo de busca; o RAG é a arquitetura inteira, que busca o trecho e entrega ao modelo de linguagem para redigir a resposta. Se a dúvida é se a empresa precisa de RAG, o assunto está em RAG em IA: quando a empresa nem precisa. Aqui, o foco é a peça que escolhe o trecho.
Como o embedding encontra o trecho certo?
O processo tem duas etapas. Na preparação, a base é dividida em trechos, cada trecho vira um vetor, e os vetores vão para o banco. Na consulta, a pergunta do usuário também vira vetor, e o sistema procura os trechos cujos vetores estão mais perto dela.
A medida de "perto" mais usada é a similaridade de cosseno, que compara a direção de dois vetores. A OpenAI recomenda o cosseno e informa que seus embeddings já vêm normalizados para comprimento 1 — com isso, o cálculo vira um produto escalar, e cosseno e distância euclidiana dão o mesmo ranking. A própria documentação diz que a escolha da função de distância costuma importar pouco.
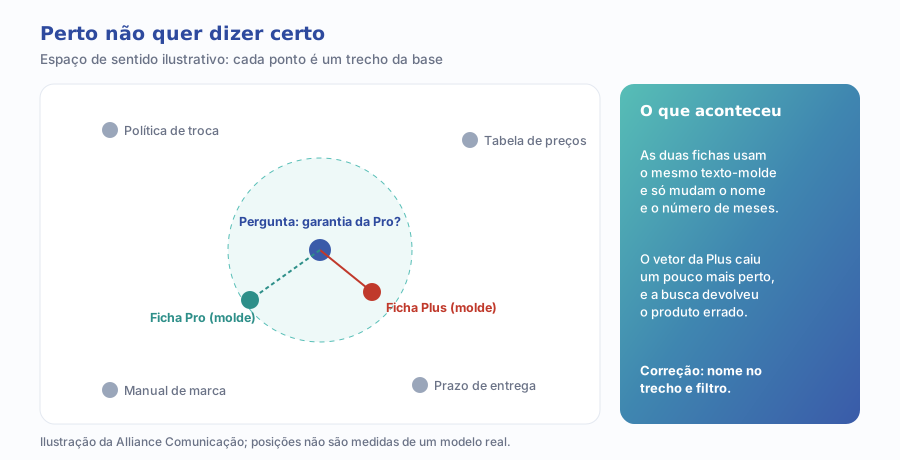
Repare no que o mapa mostra: o sistema devolve os trechos mais próximos, não os trechos corretos. Na maioria das vezes, as duas coisas coincidem. Quando não coincidem, o erro chega ao usuário com a mesma confiança de um acerto.
Por que "parecido" não é "correto" na base da marca?
Porque o embedding codifica o assunto e o tom do trecho, e as fichas de uma mesma marca costumam ter assunto e tom quase idênticos. Imagine duas fichas escritas a partir do mesmo modelo: "A linha Pro conta com garantia de 24 meses, assistência em todo o Brasil e…" e "A linha Plus conta com garantia de 12 meses, assistência em todo o Brasil e…". Para o modelo de embedding, as duas dizem praticamente a mesma coisa. A única diferença que importa ao cliente — o número de meses e o nome do produto — pesa pouco no vetor.
O resultado é um sistema que acerta o assunto e erra o produto. Ele não inventa do nada; ele troca um fato verdadeiro por outro fato verdadeiro da mesma marca, o que é mais difícil de perceber numa revisão rápida. É um parente próximo da alucinação, que explicamos em quando o bot inventa a sua marca, mas com causa diferente: a falha está na busca, não na redação.
O embedding sabe que dois trechos falam da mesma coisa. Ele não sabe qual dos dois é o do produto que o cliente perguntou.
Outros pares que costumam se confundir na base de uma empresa: política de troca da loja física e da loja on-line, preço de tabela e preço promocional, versão antiga e versão nova do mesmo manual, condições para pessoa física e para empresa. Em todos, o texto é quase igual e a diferença está num detalhe.
Quanto custa gerar embeddings?
Pouco — e este é o ponto em que a teoria assusta mais do que a conta. Gerar o vetor de um trecho é uma operação muito mais barata do que pedir a um modelo de linguagem que escreva uma resposta.
Para dar escala: uma base de marca com 500 páginas — manual, fichas de produto, políticas, perguntas frequentes — custaria menos de um centavo de dólar no modelo pequeno, pela própria conta de páginas por dólar da tabela. Mesmo regenerando tudo a cada atualização, o custo de gerar vetores raramente é o que pesa no orçamento.
O que pesa está em volta: o banco de dados vetorial (hospedado ou próprio), as chamadas ao modelo de linguagem que redige a resposta e, principalmente, as horas de quem prepara e mantém a base. O orçamento de um assistente com base própria é quase todo conteúdo e operação, não vetor.
Qual modelo de embedding usar?
A referência mais usada para comparar modelos é o MTEB (Massive Text Embedding Benchmark), proposto em 2022 por Niklas Muennighoff, Nouamane Tazi, Loïc Magne e Nils Reimers. Ele cobre 8 tarefas, 58 conjuntos de dados e 112 idiomas, e a conclusão do artigo que apresentou o benchmark vale até hoje: nenhum método de embedding domina todas as tarefas.
Para quem está montando a base da marca, isso se traduz em três critérios práticos, mais úteis que a nota geral do ranking:
| Critério | Modelo menor (ex.: 3-small) | Modelo maior (ex.: 3-large) |
|---|---|---|
| Custo por página | Cerca de 62.500 páginas por dólar | Cerca de 9.615 páginas por dólar |
| Nota no MTEB | 62,3% | 64,6% |
| Dimensões padrão | 1.536 | 3.072 |
| Espaço no banco vetorial | Menor | O dobro, se não encurtar |
| Quando faz sentido | Base pequena ou média, começo do projeto | Base grande, termos técnicos, muita ambiguidade |
Números da tabela de modelos do guia "Vector embeddings" da OpenAI, consultado em 11/11/2026.
O primeiro critério é o idioma: a base está em português, e a pergunta do cliente também. Teste o modelo com perguntas reais em português antes de olhar a média do ranking. O segundo é o tamanho do vetor: a OpenAI informa que o parâmetro dimensions encurta o vetor com perda pequena — no exemplo da documentação, o modelo grande reduzido a 256 dimensões supera o antigo ada-002 com 1.536. O terceiro é a troca: mudar de modelo obriga a regenerar todos os vetores, porque vetores de modelos diferentes não são comparáveis entre si.
Um detalhe de documentação que vale saber: a OpenAI registra que os modelos de terceira geração não conhecem eventos posteriores a setembro de 2021. Para embedding isso pesa menos que para um modelo de conversa, mas nomes de produto e termos criados depois disso podem ser representados com menos precisão.
Como preparar a base da marca para virar embedding?
É aqui que se ganha ou se perde a qualidade da busca — e é trabalho de conteúdo, não de programação. O limite de 8.192 tokens por entrada já obriga a picotar documentos longos; a questão é picotar do jeito certo.
1. Um assunto por trecho
Trecho que fala de garantia, preço e prazo de entrega ao mesmo tempo vira um vetor "médio", que fica perto de tudo e não ganha de ninguém. Divida pelo assunto, não pelo número de caracteres: cada trecho responde a uma pergunta.
2. O nome do produto em cada bloco
Depois de picotado, o trecho perde o título da página. "A garantia é de 24 meses" não diz de qual produto. Escreva "A garantia da linha Pro é de 24 meses" — o nome explícito puxa o vetor para perto das perguntas sobre aquele produto.
3. Sem texto-molde
As fichas iguais com troca de um número são o pior caso para embedding. Reescreva o que diferencia cada produto no começo do trecho e corte o texto repetido de todas as fichas, que só aumenta a semelhança entre elas.
4. Metadado fora do texto
Guarde junto de cada trecho, como campo separado, o produto, a versão e a data. A busca pode filtrar por esses campos antes de comparar vetores — "só trechos da linha Pro" — e o filtro resolve o que a proximidade não resolve.

Para bases grandes, o tamanho do trecho também conversa com a janela de contexto do modelo que vai redigir a resposta — o que entra e o que se perde no meio está em janela de contexto: o manual que a IA esquece no meio.
Quais os erros mais comuns com embeddings?
- Picotar por tamanho fixo. O corte no meio de uma frase separa a pergunta da resposta.
- Manter versões antigas na base. O manual de 2023 e o de 2026 ficam vizinhos, e o antigo pode ganhar.
- Confiar só na proximidade. Sem filtro por produto ou data, o trecho vizinho passa como certo.
- Trocar de modelo sem regenerar. Vetores de modelos diferentes não se comparam.
- Escolher pelo ranking geral. A nota média não diz como o modelo vai em português e no vocabulário da sua marca.
- Ignorar busca por palavra. Código de produto, número de série e sigla interna são achados melhor por correspondência exata; muitos sistemas combinam as duas buscas.
- Não testar com perguntas reais. A base parece boa até alguém perguntar do jeito que o cliente pergunta.
Como medir se a busca por embeddings está acertando?
Não dá para avaliar embedding olhando os números. Dá para avaliar o que ele devolve. O método mais simples, e o que usamos, é um conjunto de perguntas de teste com resposta conhecida:
- Monte 30 a 50 perguntas reais, tiradas do atendimento, do comercial e do SAC, escritas do jeito que o cliente escreve.
- Marque o trecho certo de cada uma na base — o trecho que um humano usaria para responder.
- Rode a busca e veja se o trecho certo aparece entre os três primeiros devolvidos.
- Separe os erros por tipo: assunto errado, produto vizinho, versão antiga, trecho que não existe.
- Corrija a base, não só o sistema, e rode o mesmo teste de novo a cada mudança de conteúdo ou de modelo.
Por onde começar hoje?
Comece pelo inventário, não pela ferramenta. Liste os documentos que o assistente vai usar, marque os que existem em mais de uma versão e os que seguem o mesmo molde. Esse mapa mostra onde a busca vai tropeçar antes de qualquer vetor ser gerado. Montar e manter essa base, escrita para ser encontrada por IA, é o trabalho de uma base de conhecimento de marca para IA.
Depois, escolha um modelo pequeno, gere os vetores, monte as 30 perguntas de teste e meça. Se o modelo grande não melhorar o resultado do teste, a diferença de custo não se paga. E, se a dúvida for onde a IA entra no seu marketing como um todo, o diagnóstico de marketing gratuito da Alliance leva cerca de 30 minutos e mostra o nível de maturidade da empresa em tecnologia e automação.