Durante anos, o artigo da central de ajuda teve um leitor só: o cliente que chegava pela busca, lia a página de cima a baixo e, se não achasse a resposta, abria um chamado. Esse leitor ainda existe. Mas, em muitas empresas, ele deixou de ser o primeiro a abrir o artigo.
Quem lê primeiro agora é o agente de IA do atendimento. Ele não vê a página: vê pedaços dela, escolhidos por uma busca, e responde com o que encontrou. Este guia explica o que é base de conhecimento, como a IA usa esse conteúdo e, principalmente, como escrever, datar e manter cada artigo para que a resposta que sai do robô seja a certa.
O que é base de conhecimento?
Base de conhecimento é uma biblioteca de artigos curtos, organizada por assunto, que responde às dúvidas recorrentes sobre um produto, um serviço ou um processo. Pode ser externa, aberta ao cliente numa central de ajuda, ou interna, usada pela equipe de atendimento, vendas e operação.
O formato clássico é conhecido: categorias, busca no topo, artigos do tipo passo a passo, solução de problema e política. O objetivo também: deixar o cliente resolver sozinho e tirar do atendimento humano a pergunta que se repete todo dia.
O que mudou foi o uso. Plataformas de atendimento, assistentes corporativos e as APIs de modelos de linguagem passaram a aceitar a base de conhecimento como fonte de resposta do agente de IA. O mesmo artigo que o cliente lia agora alimenta um robô que conversa por chat, WhatsApp ou e-mail — e que responde em nome da marca.
Qual a diferença entre base de conhecimento e FAQ?
FAQ é uma página com as perguntas mais frequentes e respostas curtas, quase sempre numa lista única. Base de conhecimento é um acervo: muitos artigos, cada um com seu endereço, organizados por tema, com profundidade para resolver o problema inteiro. Uma FAQ pode existir dentro da base, mas não substitui a base.
Quando a IA entra na história, a diferença ganha uma terceira coluna. O artigo que funciona para a máquina tem regras que nem a FAQ nem a base tradicional costumavam seguir:
| FAQ | Base de conhecimento tradicional | Base lida por IA | |
|---|---|---|---|
| Unidade | Uma pergunta numa lista | Um artigo com URL própria | Um trecho recortado do artigo |
| Quem lê | Cliente, de passagem | Cliente e atendente | O agente de IA, antes do cliente |
| Tamanho | Duas ou três frases | Livre, às vezes longo | Resposta tem de caber num trecho |
| Data e dono | Raramente | Às vezes, escondidos | Obrigatórios, para filtrar e expirar |
| Erro típico | Resposta rasa | Artigo desatualizado esquecido | Trecho vencido citado com confiança |
Comparativo elaborado pela Alliance Comunicação com base na documentação das plataformas citadas neste artigo.
Como a IA usa a base de conhecimento no atendimento?
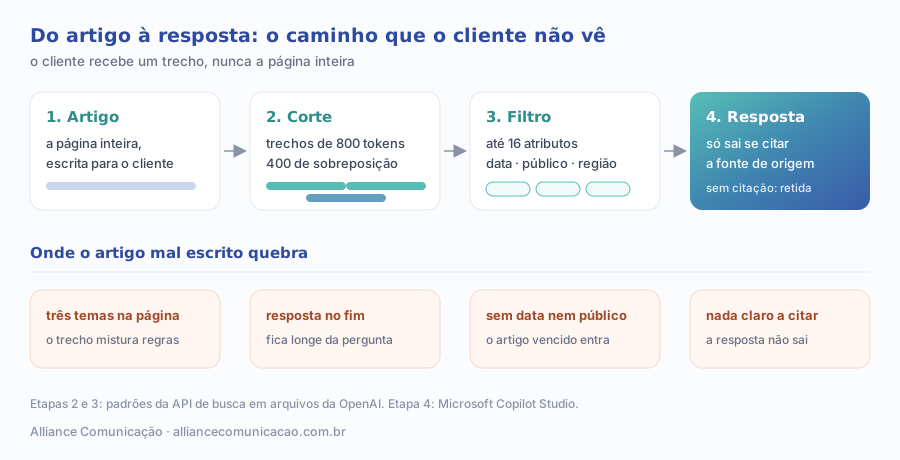
O caminho tem quatro etapas, e o cliente não vê nenhuma delas. Primeiro, a empresa entrega os artigos à plataforma. Depois, a plataforma corta cada artigo em trechos e guarda esses trechos num índice de busca. Quando chega uma pergunta, o sistema procura os trechos mais parecidos com ela, aplica filtros e entrega alguns ao modelo. Por fim, o modelo escreve a resposta usando só aquele material.
A decisão técnica entre colar um documento na instrução do agente ou montar essa busca automática em documentos é outro assunto — tratamos dela em quando a empresa nem precisa de RAG. Aqui o foco é o que vem antes: o texto que vai ser recortado.
O tamanho do recorte não é abstrato. Na API da OpenAI para busca em arquivos, por exemplo, o padrão está documentado:
O que muda quando quem lê o artigo é a máquina?
Muda a unidade de leitura. O cliente humano lê a página e junta as partes na cabeça: o aviso do terceiro parágrafo, a exceção da nota de rodapé, a tabela do fim. O agente de IA recebe um ou alguns trechos, e o que ficou fora deles, para aquela resposta, não existe.
Isso tem três consequências práticas. A primeira: a resposta precisa caber num trecho. Se o artigo leva cinco parágrafos de contexto antes de dizer o prazo, o trecho recortado pode trazer o contexto e deixar o prazo de fora.
A segunda: o assunto precisa ser um só. Um artigo que trata de segunda via, boleto vencido e troca de vencimento na mesma página gera trechos que misturam três regras. A busca acha o trecho certo pela metade, e o modelo responde com a regra do vizinho.
A terceira: o artigo precisa dizer quando vale e para quem. Sem data, sem público e sem validade, a política de 2024 e a de 2026 parecem igualmente verdadeiras para a busca. O modelo não tem como saber que uma delas morreu.
O que a documentação das plataformas mostra?
A melhor régua para escrever para a IA não é a opinião de quem vende ferramenta: é a documentação de quem constrói o mecanismo. E ela é explícita em dois pontos que mexem diretamente com a forma do artigo.
O primeiro é o recorte com metadado, que a OpenAI documenta acima: o artigo é fatiado e cada arquivo pode carregar atributos que servem de filtro. Quem não preenche data, público ou região entrega à busca uma pilha sem etiqueta.
O segundo é a exigência de citação. No Copilot Studio, da Microsoft, a empresa pode impedir que o agente responda sem se apoiar numa fonte — e a fonte é escolhida, em parte, pela descrição que alguém escreveu para ela:
Juntas, as duas regras dizem a mesma coisa: a IA só é tão precisa quanto o artigo é recortável, etiquetado e citável. Um artigo com a resposta clara num parágrafo é fácil de citar. Um artigo vago, que espalha a resposta pela página, produz resposta retida — ou, onde a trava não está ligada, resposta inventada a partir de pedaços.
E a descrição da fonte, que quase ninguém escreve com cuidado, vira critério de escolha quando a base cresce. "Documentos do financeiro" diz pouco. "Segunda via, vencimento e multa de boletos de clientes pessoa jurídica" diz à máquina quando aquela fonte serve.
Como escrever um artigo de base de conhecimento para chatbot?
As regras abaixo saem da forma como os mecanismos funcionam, não de gosto editorial. Valem para a central de ajuda aberta e para a base interna que alimenta o assistente da equipe.
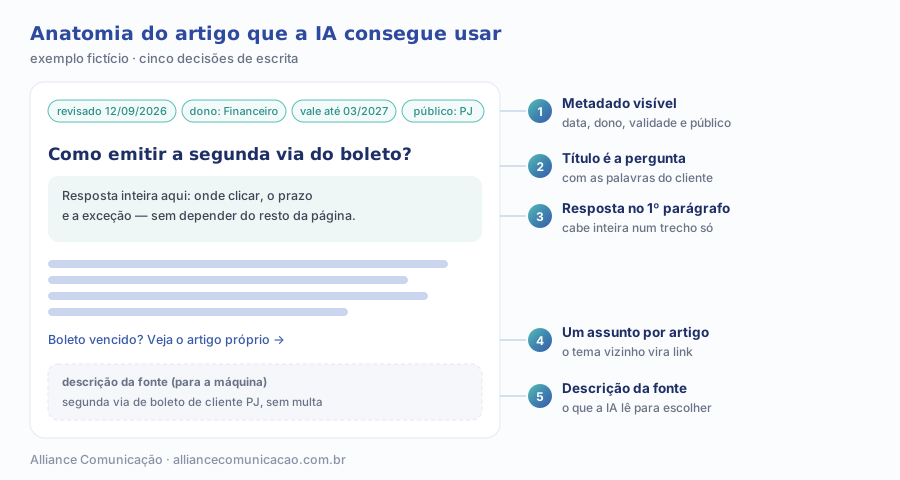
1. Um assunto por artigo
Se a pergunta do cliente é uma, o artigo trata dela e de nada mais. O tema vizinho ganha artigo próprio e entra como link no fim. Isso deixa cada trecho recortado com uma regra só e facilita a busca encontrar o pedaço certo.
2. Título escrito como a pergunta
"Como emitir a segunda via do boleto?" funciona melhor que "Faturamento — procedimentos". O título em pergunta aproxima o texto do jeito que o cliente escreve no chat, e a busca por similaridade trabalha justamente com essa proximidade.
3. Resposta inteira no primeiro parágrafo
Duas ou três frases que resolvem: onde clicar, qual o prazo, qual a exceção. O detalhe vem depois. Se o recorte pegar só o começo do artigo, a resposta já está nele — e é esse o trecho mais fácil de citar.
4. Termos fixos, sem sinônimo criativo
Se o produto chama "plano Pro", o artigo não alterna com "versão avançada" e "pacote premium". Para o cliente, é estilo; para a busca, são coisas diferentes. A mesma disciplina vale para a voz da marca, que tratamos em tom de voz da marca escrito para a IA.
5. Data, dono e validade à vista
No topo do artigo e nos atributos da plataforma: quando foi revisado, quem responde por ele, até quando vale e para qual público. Visível para o leitor humano e preenchido como metadado para o filtro.
6. Descrição da fonte escrita para a máquina
Cada coleção de artigos entregue ao agente precisa de uma descrição objetiva do que cobre e do que não cobre. É o texto que o orquestrador lê para decidir onde procurar. Escreva como se fosse a instrução de um estagiário no primeiro dia.
Que metadados cada artigo precisa carregar?
Metadado é a etiqueta que a máquina usa para filtrar e que o time usa para manter. Não precisa de muitos; precisa dos que respondem às perguntas "vale agora?", "vale para quem?" e "quem conserta?". A tabela traz o mínimo útil:
| Campo | Para que serve | Exemplo |
|---|---|---|
| Revisado em | Mostrar quando alguém confirmou o conteúdo | 12/09/2026 |
| Válido até | Tirar do ar ou revisar automaticamente | Fim da campanha, troca de tabela |
| Dono | Saber quem corrige quando a IA erra | Financeiro, Produto, Jurídico |
| Público | Não responder a PF com regra de PJ | Cliente PJ, revenda, interno |
| Região ou unidade | Separar regra que muda por lugar | São Paulo, Nordeste, loja física |
| Tipo | Diferenciar passo a passo, política e aviso | Procedimento, política, comunicado |
Campos sugeridos pela Alliance Comunicação; a OpenAI documenta até 16 atributos por arquivo para filtrar a busca.
Dois cuidados. Primeiro, o metadado precisa bater com o texto: um artigo marcado como válido até março que fala de uma condição encerrada em janeiro ensina a máquina a desconfiar de tudo. Segundo, metadado sem dono vira campo vazio em seis meses — o dono é o campo que garante os outros.
Com que frequência atualizar a base de conhecimento?
Não existe um número certo, e desconfie de quem oferece um. A frequência é dada pelo ritmo de mudança do que o artigo descreve: preço, prazo, política comercial e telas do sistema mudam mais rápido que a explicação de um conceito. O que funciona é trocar o calendário fixo por gatilhos.
- Gatilho de mudança: mudou preço, prazo, política ou tela, o artigo correspondente entra em revisão no mesmo dia — antes da mudança ir ao ar, de preferência.
- Gatilho de validade: o campo "válido até" chegou, o artigo sai da fonte da IA até alguém confirmar.
- Gatilho de erro: o atendimento humano corrigiu uma resposta do robô, o artigo citado volta para o dono.
- Gatilho de silêncio: pergunta frequente sem artigo que a responda vira pauta de artigo novo.
A rotina mais negligenciada é a de expirar. Base de conhecimento cresce por acúmulo: entra artigo novo, o antigo fica. Para o leitor humano, o artigo velho só ocupa espaço. Para a IA, é uma fonte ativa, recortada e citável — o artigo vencido que ninguém apagou continua respondendo.
Quais os erros mais comuns ao entregar a base para a IA?
- Despejar tudo de uma vez: manuais, apresentações e e-mails antigos entram sem curadoria e competem com os artigos certos.
- Artigo-gaveta: uma página com dez assuntos, que gera trechos ambíguos e respostas misturadas.
- Resposta no fim: contexto longo antes do que interessa, e o recorte separa a pergunta da resposta.
- PDF escaneado como fonte: imagem de texto não é texto; o que a máquina não consegue ler não entra no índice.
- Duas versões vivas: a política nova publicada sem despublicar a antiga, e o robô alternando entre elas.
- Descrição genérica da fonte: "documentos gerais" não ajuda o orquestrador a escolher onde procurar.
- Ninguém é dono: o erro aparece no chat, mas não existe a quem devolver o artigo.
Quase todos esses erros são de conteúdo, não de tecnologia. Trocar de ferramenta não resolve artigo-gaveta nem política duplicada. É por isso que o trabalho de base de conhecimento de marca começa pelo inventário e pela reescrita, e só depois pela configuração.
Como medir se a IA está respondendo com a base certa?
- Taxa de resposta com citação: das perguntas respondidas pelo agente, quantas trazem a fonte. Onde a citação é obrigatória, a taxa de resposta retida mostra o tamanho do buraco.
- Idade da fonte citada: a data de revisão dos artigos que a IA mais usa. Se os mais citados são os mais velhos, a revisão está no lugar errado.
- Correções humanas: quantas respostas do robô o atendente precisou corrigir, e de quais artigos elas saíram.
- Perguntas sem artigo: o que os clientes perguntam e não encontra trecho correspondente — é a pauta da próxima rodada.
- Transbordo para humano: em quais assuntos a conversa sai do robô; assunto com muito transbordo costuma ter artigo fraco.
Nenhuma dessas métricas exige ferramenta nova. A maioria das plataformas registra a conversa e a fonte usada; o que falta, em geral, é alguém olhar a lista toda semana e devolver os artigos aos donos.
Por onde começar hoje
Não comece reescrevendo a base inteira. Comece pelas perguntas que mais chegam, porque são elas que a IA vai responder primeiro e com mais frequência.
- Liste as 20 perguntas mais frequentes do atendimento e encontre o artigo que responde cada uma.
- Para cada artigo, confira: um assunto só, título em pergunta, resposta no primeiro parágrafo.
- Preencha data de revisão, dono, validade e público — no texto e nos atributos da plataforma.
- Despublique as versões antigas e duplicadas antes de ligar o agente.
- Escreva a descrição de cada fonte dizendo o que ela cobre e o que não cobre.
- Rode o teste das cinco perguntas toda semana e devolva cada erro ao dono do artigo.
Se a sua empresa também quer ser bem lida pelas IAs de fora — ChatGPT, Gemini, Perplexity —, o mesmo princípio vale para o site, e o llms.txt é uma das peças. Para saber onde a comunicação da sua marca está hoje, do conteúdo ao atendimento, faça o diagnóstico de marketing gratuito da Alliance.