Quem trabalha com mídia já ouviu a frase: “pode subir a lista, o e-mail vai criptografado, é anônimo”. Ela mistura três coisas diferentes. Hash não é criptografia, criptografia não é anonimização, e um dado só é anônimo, para a LGPD, quando ninguém consegue voltar à pessoa com esforço razoável. A lista de clientes enviada a uma plataforma de anúncios foi feita justamente para voltar à pessoa.
Este artigo explica o que são dados anonimizados pela lei, como eles se diferenciam dos pseudonimizados e onde caem os dados que o marketing usa todo dia: a lista com hash, o ID de cookie, o segmento comportamental, o relatório de campanha. No fim, mostra a saída que a própria LGPD oferece para guardar histórico de leads para BI sem guardar as pessoas, e um teste para aplicar à sua base. É conteúdo informativo, não parecer jurídico: cada caso concreto pede análise própria.
O que são dados anonimizados na LGPD?
A Lei Geral de Proteção de Dados (Lei nº 13.709/2018, no texto do Planalto) define dado anonimizado no art. 5º, III: é o dado relativo a titular que não possa ser identificado, considerando a utilização de meios técnicos razoáveis e disponíveis na ocasião de seu tratamento. Repare nas três partes da frase: o dado era de alguém, esse alguém não pode mais ser identificado, e a medida é o que é razoável e disponível naquele momento.
A lei também define o processo. Anonimização, no art. 5º, XI, é a utilização de meios técnicos razoáveis e disponíveis no momento do tratamento para que um dado perca a possibilidade de associação, direta ou indireta, a um indivíduo. “Direta ou indireta” é o trecho que derruba a maior parte das anonimizações caseiras: apagar o nome é cortar a associação direta, mas a combinação de CEP, data de nascimento e cargo pode refazer a indireta.
Um exemplo simples: o relatório que mostra o total de aberturas da campanha de setembro, dividido por tipo de aparelho, é um dado anonimizado. Ela nasceu de dados pessoais (quem abriu, de qual aparelho), mas não aponta para ninguém. Já a planilha “cliente 4471 abriu a campanha às 9h12 no iPhone” não é, mesmo sem nome: o código 4471 existe para ser ligado a um cadastro.
Dados anonimizados são considerados dados pessoais?
Em regra, não. O art. 12 da LGPD diz que os dados anonimizados não serão considerados dados pessoais para os fins da lei. Na prática, isso significa que, uma vez anonimizado de verdade, o dado sai do alcance das bases legais, dos direitos do titular e das regras de retenção. É por isso que a anonimização interessa tanto ao marketing: ela é a porta de saída da lei.
A porta, porém, tem duas trancas no mesmo artigo. A primeira está no caput: o dado volta a ser pessoal quando a anonimização for revertida usando exclusivamente meios próprios, ou quando, com esforços razoáveis, puder ser revertida. A segunda está no § 1º, que diz como medir o “razoável”: por fatores objetivos, como custo e tempo para reverter, de acordo com as tecnologias disponíveis.
Daí sai a regra prática mais útil do artigo inteiro: anonimização não é um estado permanente, é uma avaliação de risco. Uma base que era anônima pode deixar de ser quando a empresa compra outra base que permite cruzar, ou quando a tecnologia barateia a reidentificação. Quem guarda dado “anonimizado” precisa reavaliar de tempos em tempos.
Qual a diferença entre dados anonimizados e pseudonimizados?
Os dois processos tiram o nome do dado. A diferença está em quem consegue colocá-lo de volta. No dado anonimizado, ninguém consegue com esforço razoável, nem a própria empresa. No pseudonimizado, a empresa consegue, porque guarda separadamente a informação que liga o pseudônimo à pessoa: a tabela de correspondência, a chave, o cadastro original.
A LGPD define pseudonimização no art. 13, § 4º: o tratamento por meio do qual um dado perde a possibilidade de associação, direta ou indireta, a um indivíduo, senão pelo uso de informação adicional mantida separadamente pelo controlador em ambiente controlado e seguro. Um cuidado de leitura: o próprio parágrafo diz que a definição vale “para os efeitos deste artigo”, que trata de estudos em saúde pública. A lei não tem uma regra geral de pseudonimização; o conceito é usado, por extensão, para entender o resto.
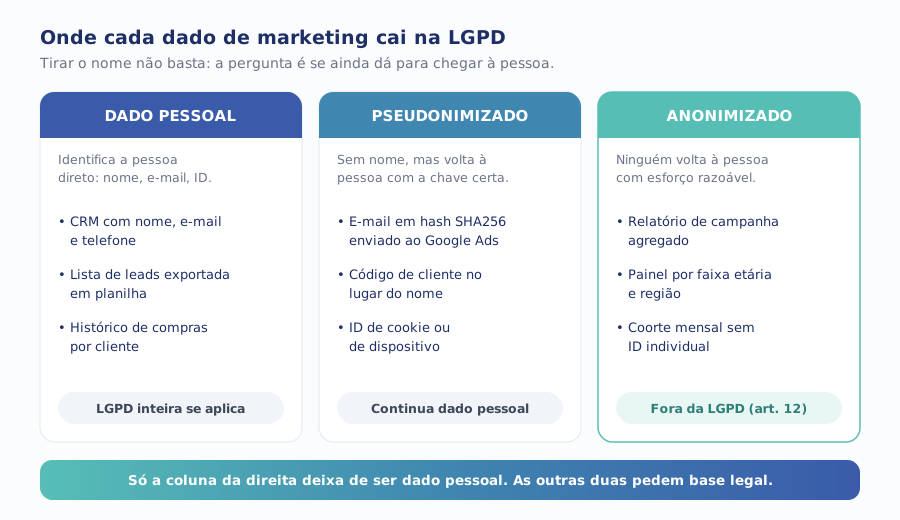
O estudo técnico da ANPD descreve a pseudonimização como substituição de identidade: os identificadores diretos são trocados por pseudônimos, como códigos ou números aleatórios, e a identificação continua possível para quem tem acesso ao segredo guardado à parte. Como a reversão é possível com meios próprios, o dado pseudonimizado continua sendo dado pessoal pelo art. 12. Ele é mais seguro, não mais livre.
| Dado pessoal | Pseudonimizado | Anonimizado | |
|---|---|---|---|
| Identifica a pessoa? | Sim, direta ou indiretamente | Não sozinho; sim com a informação guardada à parte | Não, com esforço razoável |
| É dado pessoal na LGPD? | Sim | Sim (a reversão é possível com meios próprios) | Não (art. 12), salvo se puder ser revertido |
| Precisa de base legal? | Sim | Sim | Não, depois de anonimizado |
| Titular tem direitos sobre ele? | Sim | Sim | Não sobre o resultado anônimo |
| Exemplo de marketing | CRM com nome e e-mail | E-mail em hash para o Google Ads; código de cliente | Relatório agregado de campanha |
| Para que serve | Operar a relação com o cliente | Reduzir exposição sem perder o vínculo | Estatística, BI, histórico sem pessoa |
Elaborado pela Alliance Comunicação a partir da Lei nº 13.709/2018 (LGPD), art. 5º, III e XI, art. 12 e art. 13, § 4º.
O e-mail com hash da lista de anúncios é anônimo?
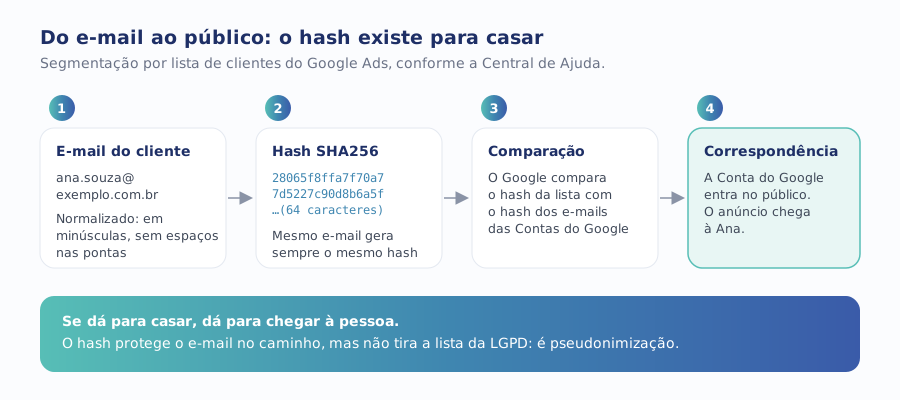
Não, e a documentação da própria plataforma mostra por quê. Na Segmentação por lista de clientes do Google Ads, o anunciante monta um arquivo com e-mail, telefone, nome e sobrenome dos clientes. Pode aplicar o hash SHA256 por conta própria ou deixar que o Google Ads aplique. Antes do hash, a ajuda pede para normalizar: tirar espaços das pontas e passar tudo para minúsculas.
A normalização é a pista. Ela existe porque o hash é determinístico: o mesmo texto sempre gera a mesma sequência. Fizemos o teste: “ana.souza@exemplo.com.br” gera um hash; o mesmo endereço com maiúsculas e espaços gera outro, completamente diferente. Se a lista não for normalizada, não casa. E casar é exatamente o objetivo.
Leia de novo a mecânica com o art. 12 ao lado. O hash é trocado por uma conta específica, de uma pessoa específica, que vai receber um anúncio específico. A informação adicional que permite reverter (o e-mail original) está com o anunciante, no CRM, e a plataforma tem a sua própria tabela de e-mails e hashes. Pela leitura do art. 13, § 4º, isso é pseudonimização: o dado perde a associação direta, mas pode ser religado. Logo, continua sendo dado pessoal.
Isso não quer dizer que a lista de clientes seja proibida. Quer dizer que ela precisa do que todo tratamento de dado pessoal precisa: uma base legal que a sustente, transparência na política de privacidade sobre o envio a plataformas de anúncio, e respeito a quem pediu para sair. O hash é uma boa medida de segurança; ele não substitui nenhum desses itens. O mesmo raciocínio vale para as conversões offline com e-mail do lead em hash: o envio é útil e legítimo quando tem base, não porque o hash o tornaria anônimo.
Se o dado foi feito para encontrar a pessoa, ele não é anônimo. É só um pseudônimo com destino.
Segmentar sem nome escapa da LGPD?
Não escapa, e a lei tem um parágrafo escrito para esse caso. O art. 12, § 2º, diz que poderão ser considerados dados pessoais aqueles utilizados para formação do perfil comportamental de determinada pessoa natural, se identificada. A segmentação de audiência faz exatamente isso: junta navegação, cliques e compras para decidir que aquela pessoa recebe aquela mensagem.
O argumento “mas o segmento não tem nome” não resolve. O ID de cookie, o ID de dispositivo e o código do cliente no CRM são pseudônimos: não dizem o nome, mas apontam sempre para o mesmo navegador, o mesmo aparelho, o mesmo cadastro. Quando esse identificador encontra um login, um formulário ou uma compra, o perfil ganha nome. É por isso que o banner de cookies e a política de privacidade continuam valendo para quem diz que “só trabalha com dado anônimo”.
Vale o mesmo para os segmentos inferidos. Um público de “prováveis compradores de produto para diabetes” não tem nome na planilha, mas é aplicado a pessoas reais. Se o perfil revelar algo como saúde ou vida sexual, entra ainda a camada de dados sensíveis na LGPD, com regras mais estreitas.
O que é anônimo de verdade no marketing?
O que costuma passar no teste é o agregado: números sobre grupos, não sobre pessoas. É o relatório da campanha (impressões, cliques, conversões por canal), o painel de vendas por região e faixa etária, a coorte de clientes que entraram em março e quantos compraram de novo em junho, sem nenhum identificador individual na tabela final.
Mesmo o agregado tem uma armadilha: o grupo pequeno. Uma linha que diz “clientes de 60 a 65 anos em uma cidade pequena, plano Premium: 1” identifica alguém tão bem quanto o nome. O estudo da ANPD cita uma pesquisa de Latanya Sweeney, de 2000, segundo a qual 87% da população dos Estados Unidos tinha características provavelmente únicas com base só no CEP de cinco dígitos, no gênero e na data de nascimento. Três campos “inofensivos”, juntos, viram identificador.
A consequência prática é definir, antes de publicar um painel, um tamanho mínimo de grupo abaixo do qual a célula aparece como “menos de X” ou some. O número exato depende da base e do risco; o que não pode é não existir regra. E, ao compartilhar com terceiros, olhe as combinações de colunas, não só as colunas isoladas.
Como é feita a anonimização de dados pessoais na prática?
Não existe uma técnica única, e nenhuma vale para todo caso. O que existe é uma combinação de operações escolhidas conforme o uso que se quer do dado. As mais comuns, em linguagem de marketing:
1. Supressão
Apagar os identificadores diretos (nome, e-mail, telefone, CPF) e as colunas que não servem à análise. É o primeiro passo e, sozinho, quase nunca basta, porque deixa os identificadores indiretos no lugar.
2. Generalização
Trocar o valor exato por uma faixa: idade por faixa etária, data de nascimento por ano, CEP completo pelos primeiros dígitos ou pela cidade, valor de compra por faixa de ticket. A análise perde precisão e ganha segurança.
3. Agregação
Transformar linhas de pessoas em contagens, somas e médias por grupo. É o formato do relatório e do painel, e o mais seguro para o dia a dia do marketing, desde que os grupos não sejam pequenos demais.
4. Descarte da chave
Se a base foi pseudonimizada com códigos, ela só fica perto da anonimização quando a tabela que liga código e pessoa é destruída, e quando não sobram outros caminhos de volta. Enquanto a chave existir em algum lugar da empresa, o dado é pseudonimizado.
Note o que não está na lista: o hash simples de e-mail. Como o mesmo e-mail gera sempre o mesmo hash, quem tem uma lista de e-mails pode calcular os hashes e comparar. O hash serve para não expor o endereço no caminho; não serve para anonimizar.
Quando a empresa pode guardar dados anonimizados?
Aqui está a parte mais útil para quem tem anos de leads no CRM. O art. 15 lista quando o tratamento termina: finalidade alcançada, fim do período, pedido do titular, determinação da autoridade. E o art. 16 manda eliminar os dados pessoais após o término do tratamento, com quatro exceções. A quarta (inciso IV) autoriza a conservação para uso exclusivo do controlador, vedado o acesso por terceiro, desde que anonimizados os dados.
Traduzindo: o lead que não virou cliente, ou o cliente que saiu, não precisa sumir dos seus números. Ele precisa sumir como pessoa. Você pode manter, por exemplo, quantos leads entraram por canal em cada mês, a taxa de conversão por origem, o tempo médio até a venda e o ticket por segmento, desde que a tabela guardada não permita voltar a ninguém e fique só com a empresa.
Dois detalhes do texto da lei mudam o desenho. Primeiro, o inciso IV proíbe o acesso por terceiro: a base histórica anonimizada pela exceção do art. 16 não é para vender nem para entregar a parceiros. Segundo, o art. 18, IV, dá ao titular o direito de pedir anonimização, bloqueio ou eliminação de dados desnecessários, excessivos ou tratados em desconformidade. Ter um processo de anonimização pronto ajuda a responder a esse pedido sem perder o histórico.
Para saber o que guardar e por quanto tempo, o ponto de partida é o inventário de dados pessoais: é nele que cada tratamento ganha finalidade e prazo, e é a partir dele que se decide o que vira histórico anônimo e o que é eliminado.
Quais os erros mais comuns com dados anonimizados?
- Chamar hash de anonimização. O hash de e-mail é determinístico e serve para casar listas. É medida de segurança, não saída da lei.
- Chamar hash de criptografia. Criptografia é feita para ser revertida por quem tem a chave; hash é de mão única, mas pode ser recalculado por quem já tem o e-mail. Nenhum dos dois, sozinho, anonimiza.
- Apagar o nome e manter o resto. E-mail, telefone, CPF, IP e combinações de campos indiretos continuam identificando.
- Guardar a chave “por via das dúvidas”. Enquanto a tabela de correspondência existir, a base é pseudonimizada.
- Publicar painel com grupos minúsculos. A célula com uma pessoa é um cadastro com outro nome.
- Compartilhar a base “anônima” com parceiro. A conservação autorizada pelo art. 16, IV, é para uso exclusivo do controlador.
- Anonimizar uma vez e esquecer. O critério é o razoável “na ocasião”; uma nova base cruzável muda a resposta.
Como saber se a sua base está realmente anonimizada?
Não existe selo, e a lei não traz um número mágico. Existe um roteiro de perguntas que qualquer equipe consegue aplicar antes de tratar um conjunto de dados como fora da LGPD:
- Identificadores diretos: nome, e-mail, telefone, CPF, endereço completo e qualquer código de cliente foram retirados, e não só escondidos na visualização?
- Chave: a informação que ligaria a base de volta às pessoas foi destruída, ou continua em algum sistema da empresa ou de fornecedor?
- Combinações: testando filtros com duas ou três colunas indiretas, alguma combinação devolve uma única pessoa?
- Bases cruzáveis: a empresa tem, ou pode obter com custo e tempo razoáveis, outra base que case com esta?
- Uso: a base vai servir para tomar decisão sobre uma pessoa específica (segmentar, impactar, ofertar)? Se sim, ela precisa identificar, e não é anônima.
- Revisão: há data marcada para reavaliar o risco, por exemplo quando entrar uma nova fonte de dados?
O quinto item é o mais honesto. Se a finalidade é agir sobre alguém, o dado precisa apontar para alguém, e a pergunta deixa de ser “é anônimo?” para virar “qual é a base legal?”. Para o e-mail promocional, por exemplo, isso passa pelo teste de legítimo interesse da ANPD ou pelo consentimento.
O que muda por tipo de negócio?
A lógica é a mesma para todos, mas o ponto de atenção muda conforme o que a empresa guarda e para onde envia:
| Tipo de negócio | Onde o “anônimo” costuma falhar | O que tende a ser anônimo de fato |
|---|---|---|
| E-commerce | Lista de compradores com hash para mídia; histórico de pedidos por ID | Vendas por categoria, região e mês, com grupos grandes |
| B2B | Base com cargo, empresa e cidade: poucas pessoas por combinação | Funil por origem e setor, sem empresa nem cargo |
| Saúde, farmácia, bem-estar | Segmento inferido de compra que revela condição de saúde | Volume por categoria de produto, sem pessoa |
| Educação | Base de alunos com curso, turma e cidade | Matrículas e evasão por curso e semestre |
| SaaS e apps | ID de usuário e de dispositivo em eventos de uso | Retenção por coorte, sem ID na tabela final |
| Varejo físico | Cadastro de fidelidade ligado a CPF | Ticket médio e frequência por loja e faixa |
Elaborado pela Alliance Comunicação. Exemplos ilustrativos; cada caso exige avaliação de risco própria.
No B2B, o risco merece atenção especial: a combinação “diretora de marketing + empresa de logística + Joinville” costuma descrever uma pessoa só. No varejo e no e-commerce, o risco está menos no relatório e mais nos públicos enviados às plataformas de mídia, que é onde o remarketing com lista de clientes se encontra com a LGPD.
Por onde começar hoje?
- Liste os arquivos que a empresa chama de “anônimos” e aplique o teste de três perguntas do quadro acima a cada um.
- Reclassifique como pseudonimizado tudo que tiver código, ID ou hash ligável ao CRM, e trate como dado pessoal: base legal, prazo, acesso restrito.
- Revise as listas enviadas às plataformas de anúncio: base legal registrada, aviso na política de privacidade e exclusão de quem pediu para sair.
- Defina o histórico que interessa ao BI (indicadores por canal, mês, segmento) e monte a rotina que o gera em formato agregado.
- Ao fim do tratamento, guarde só o agregado anônimo para uso interno e elimine o resto, como pede o art. 16.
- Marque uma data para reavaliar o risco de reidentificação sempre que entrar uma nova fonte de dados.
Se a sua equipe de mídia usa listas de clientes e a de dados não sabe dizer o que é anônimo na base, os dois assuntos são um só. A Alliance conduz a adequação à LGPD aplicada ao marketing e opera tráfego pago com listas de clientes sem tratar hash como salvo-conduto. Para ver onde o seu marketing está hoje, faça o diagnóstico de marketing gratuito. A transparência sobre o envio a plataformas de anúncio também entra na política de privacidade.