Quase todo guia de SEO técnico tem um item chamado “canonical”. Ele costuma aparecer no meio de um checklist, entre HTTPS e dados estruturados, com uma instrução curta: coloque a tag e siga em frente. O problema é que a tag não decide nada sozinha, e o Google diz isso com todas as letras na própria documentação.
Este artigo explica o que é SEO técnico, onde ele termina e começa o SEO on-page, e usa a página canônica como caso de estudo: a ordem de força dos sinais, o que não serve para canonicalizar, por que o Google às vezes escolhe outra URL e como ler os três status de cópia do relatório de indexação. Os assuntos vizinhos (robots.txt, sitemap, 301 e hreflang) têm artigo próprio no blog, e o texto aponta para eles em vez de repeti-los.
O que é SEO técnico?
SEO técnico é o conjunto de cuidados que permite ao buscador encontrar, ler e guardar as páginas de um site. Não trata do que a página diz, e sim de se ela chega inteira ao índice: se o servidor responde, se a URL é única, se o robô tem permissão para entrar, se o conteúdo aparece depois que o JavaScript roda e se o Google sabe qual de várias versões parecidas é a principal.
O jeito mais útil de entender o assunto é pelas etapas da busca. O guia Como a Pesquisa Google funciona descreve três: o rastreamento, em que robôs baixam textos, imagens e vídeos das páginas encontradas; a indexação, em que o Google analisa esse conteúdo e o guarda no índice; e a exibição nos resultados. No rastreamento, o Google também renderiza a página e executa o JavaScript numa versão recente do Chrome.
Cada falha técnica corta o caminho numa dessas etapas. Robots.txt mal escrito barra o rastreamento. Conteúdo que só existe depois de um script pesado pode não ser visto na renderização. E várias URLs com o mesmo texto obrigam o Google a escolher uma delas na indexação, que é exatamente onde mora a canônica.
Como o SEO técnico contribui para o sucesso de um site?
Ele não faz o site subir; ele impede que o site fique de fora. Conteúdo bom numa página que o Google não rastreia, ou que ele considera cópia de outra, simplesmente não concorre. Por isso o SEO técnico vem antes: é a condição para o resto do trabalho valer.
O próprio guia do Google lembra que não há garantia de rastreamento, indexação ou exibição, mesmo para quem segue as regras básicas. O papel do SEO técnico é tirar do caminho os motivos evitáveis. Na prática, ele cobre cinco frentes:
- Acesso: o servidor responde, as páginas importantes não estão bloqueadas no robots.txt, cujo Disallow não tira a página do Google, e não há erro 5xx em série.
- Descoberta: links internos e um sitemap XML com as tags que o Google de fato lê.
- Renderização: o conteúdo principal aparece no HTML ou depois de um JavaScript que o robô consegue executar; o caso dos sites headless está no artigo sobre o HTML que a IA não renderiza.
- Consolidação: cada conteúdo tem uma URL principal, e as variações apontam para ela. É o tema central deste texto.
- Experiência: velocidade, estabilidade do layout e uso no celular, medidos pelas Core Web Vitals.
Qual a diferença entre SEO técnico, on-page e off-page?
As três camadas se misturam no dia a dia, mas respondem a perguntas diferentes. O técnico pergunta se o Google consegue chegar à página e guardá-la. O on-page pergunta se a página responde bem à busca. O off-page pergunta se o resto da internet confirma que aquela página merece confiança.
| SEO técnico | SEO on-page | SEO off-page | |
|---|---|---|---|
| Pergunta central | O Google consegue rastrear, renderizar e indexar? | A página responde bem à busca? | Outros sites confirmam a relevância? |
| Onde se mexe | Servidor, URLs, robots.txt, sitemap, redirecionamentos, canônica | Título, texto, intertítulos, imagens, links internos | Menções, backlinks, perfil da empresa, imprensa |
| Quem costuma fazer | Desenvolvimento e SEO juntos | Redação e SEO | SEO, relações públicas e parcerias |
| Sintoma quando falha | Página fora do índice ou indexada na versão errada | Página indexada que não ranqueia | Página boa que não ganha autoridade |
| Onde conferir | Relatório de indexação e Inspeção de URL | Consultas e cliques por página | Links externos e menções à marca |
Leitura da Alliance Comunicação; a divisão em etapas segue o guia “Como a Pesquisa Google funciona”.
A camada do meio está no artigo sobre SEO on page e o que o guia do Google diz que não conta. Aqui o foco é a de baixo, que é a menos visível e a primeira a quebrar numa mudança de plataforma.
O que é a página canônica e por que ela importa?
O Google chama de canonicalização o processo de escolher a URL que representa um conteúdo que existe em mais de um endereço. A página O que é canonicalização explica que o buscador mostra uma só versão de conteúdos duplicados nos resultados, e lista de onde essas duplicatas costumam vir:
- Variantes de região: o mesmo conteúdo para dois países em URLs diferentes.
- Variantes de dispositivo: uma versão para celular e outra para computador.
- Variantes de protocolo: a mesma página em HTTP e em HTTPS.
- Funções do site: ordenação e filtro de uma página de categoria.
- Variantes acidentais: uma versão de demonstração que ficou aberta aos robôs.
A mesma página faz uma ressalva importante: ter algum conteúdo duplicado é normal e não viola as políticas de spam do Google. Duplicata não é punição. O custo é outro: o robô gasta visitas em endereços repetidos, e a versão que aparece na busca pode não ser a que você queria mostrar, com o link de campanha, a URL com maiúscula ou a página de filtro no lugar da página principal.
Os detalhes de formato de endereço, como barra final, maiúsculas e parâmetros, estão no artigo sobre a maiúscula que vira outra página na URL. O que interessa aqui é o passo seguinte: depois que as variações existem, quem decide qual delas vale?
O Google é obrigado a seguir a tag canonical?
Não. Essa é a lacuna dos checklists. A documentação apresenta a canônica indicada pelo site como uma preferência: você pode expressá-la com as técnicas certas, mas o Google pode escolher outra página por vários motivos. Ele cruza a sua indicação com outros sinais e fica com a versão que considera mais completa e útil para o usuário.
Entre os sinais que a página sobre canonicalização cita estão se a página é servida em HTTP ou HTTPS, os redirecionamentos, a presença da URL no sitemap e a própria anotação rel="canonical". Ela também observa que a página mais rastreada costuma ser a escolhida. Ou seja: a tag é um voto pesado numa votação, não a decisão.
A tag canonical não é uma ordem ao Google; é o voto mais pesado de uma votação que o resto do site também participa.
Essa diferença entre pedir e garantir é o que separa SEO técnico de checklist. Pôr a tag é fácil. Fazer o resto do site concordar com ela (links internos, sitemap, redirecionamentos, protocolo) é o trabalho.
Quais sinais de canônica pesam mais?
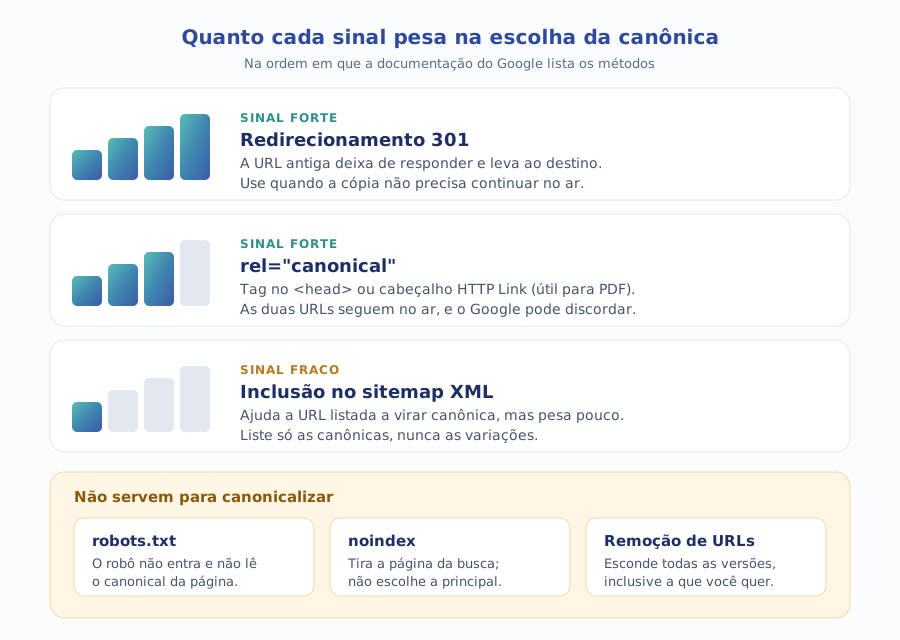
A documentação lista os métodos de canonicalização pela força com que influenciam a escolha, e os métodos se somam: usar dois ou mais aumenta a chance de a versão preferida ser a que aparece.
1. Redirecionamento: quando a cópia pode sair do ar
O redirecionamento permanente é o sinal mais forte porque não deixa dúvida: a URL antiga não mostra mais nada e leva ao destino. Serve para HTTP que vira HTTPS, domínio que muda, página que foi fundida com outra. Prazo e cuidados de migração estão no artigo sobre por quanto tempo manter o redirecionamento 301.
2. rel="canonical": quando as duas precisam continuar no ar
A tag é para o caso em que a variação tem função: o link com parâmetro de campanha, a lista ordenada por preço, a versão para impressão. Ela vai no <head> do HTML (fora dele não é aceita) ou, para arquivos como PDF, no cabeçalho HTTP Link. O Google pede URL absoluta, recomenda que cada página tenha canônica para si mesma e avisa que usar cabeçalho e tag ao mesmo tempo é mais sujeito a erro.
3. Sitemap: o reforço que não decide sozinho
Listar a URL no sitemap ajuda a indicar a preferida, mas é o sinal mais fraco dos três. Ele funciona como reforço: o sitemap deve listar só as canônicas, e nunca uma URL diferente da que a tag aponta. Indicar canônicas diferentes para a mesma página por métodos diferentes é justamente o que a documentação pede para não fazer.
Posso usar noindex ou robots.txt no lugar da canonical?
É a pergunta que mais aparece em fórum, e a resposta do Google é não para os dois.
O motivo de cada proibição é mecânico. O robots.txt impede o robô de entrar na página e, portanto, de ler a tag canonical que está lá dentro; a documentação lembra que URLs bloqueadas podem até ser indexadas sem o conteúdo. O noindex tira a página da busca por completo, o que é outra decisão: em vez de dizer “a principal é aquela”, diz “esta não existe”. E a remoção de URLs esconde todas as versões, inclusive a que você queria mostrar.
Em resumo: noindex é para página que não deve aparecer nunca (área logada, resultado de busca interna); canonical é para página que tem uma versão principal em outro endereço. Trocar um pelo outro resolve o sintoma errado.
Como ler os status de cópia no Search Console?
A divergência entre o que o site pede e o que o Google escolhe não fica escondida. Ela aparece no relatório de indexação de páginas, na lista de motivos pelos quais as páginas não estão indexadas. O Search Console tem limites que vale conhecer, mas aqui ele é direto.
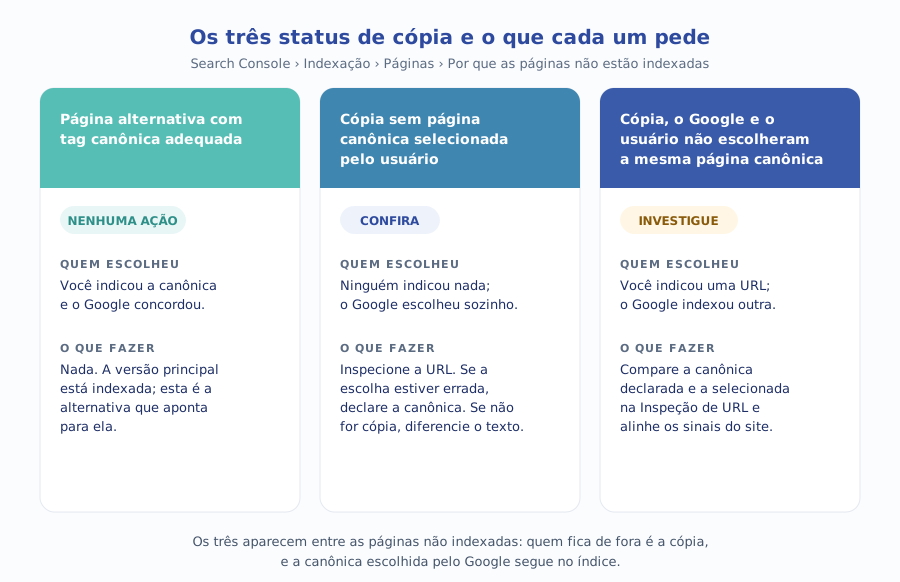
Os três aparecem entre as páginas não indexadas, e isso assusta quem olha o número total. Mas, nos três casos, a cópia ficou de fora porque uma canônica foi encontrada e indexada. A pergunta útil não é “por que esta URL não está no Google”, e sim “a URL que ficou no lugar dela é a que eu quero”. O artigo sobre por que o pedido de indexação não garante nada trata dos outros status do mesmo relatório.
A ferramenta para responder é a Inspeção de URL. Ela mostra lado a lado a canônica declarada pelo usuário e a canônica selecionada pelo Google. Se a escolha do Google estiver errada, a ajuda do Search Console orienta a indicar a canônica de forma explícita; se a página não for de fato uma cópia, a orientação é diferenciar o conteúdo.
Por que o Google escolheu uma canônica diferente da minha?
A documentação não traz uma lista fechada de motivos, mas os sinais que ela descreve apontam onde procurar. Na leitura da Alliance, a divergência quase sempre nasce de sinais que se contradizem:
- O sitemap lista uma URL e a tag aponta outra. Dois métodos indicando canônicas diferentes, exatamente o que o Google pede para evitar.
- Os links internos apontam para a variação. O menu leva à versão sem barra, a tag aponta a versão com barra. O Google recomenda linkar sempre para a canônica.
- A versão HTTPS tem problema. O Google prefere HTTPS, exceto quando o certificado é inválido, a página carrega dependências inseguras, redireciona para HTTP ou tem canonical apontando para HTTP.
- O JavaScript troca a canônica. Em sites renderizados no navegador, a documentação pede a canônica já no HTML de origem, sem script alterando depois.
- A tag está no lugar errado ou com caminho relativo. Fora do
<head>ela não vale; com caminho relativo, funciona, mas não é o recomendado. - As páginas não são cópias de verdade. Se a “canônica” tem menos conteúdo que a variação, o Google pode preferir a mais completa.
Em sites com várias línguas há um caso à parte: canonical apontando para a versão em outro idioma contradiz o hreflang. A regra de cada versão ser canônica de si mesma está no artigo sobre o link de volta que o hreflang exige.
Quais são os erros mais comuns de canonicalização?
- Canonical de todas as páginas apontando para a home. Costuma vir de tema ou plugin mal configurado, e diz ao Google que o site inteiro é cópia de uma página só.
- Canonical para URL que redireciona ou dá erro. A canônica declarada deve responder 200; apontar para endereço que redireciona manda dois sinais diferentes.
- Usar noindex na variação e canonical ao mesmo tempo. Uma instrução diz “a principal é aquela”, a outra diz “esta não existe”.
- Bloquear as variações no robots.txt. O robô não entra e nunca lê a tag.
- Tratar o status de cópia como erro. Perseguir zero páginas não indexadas, quando a meta é ter as canônicas certas indexadas.
- Corrigir a tag e esquecer o resto. Sem alinhar links internos, sitemap e redirecionamentos, a tag continua perdendo a votação.
O que muda por tipo de site?
O princípio é o mesmo em qualquer site, mas a origem das duplicatas e o sinal mais adequado variam bastante.
| Tipo de site | De onde vêm as cópias | Sinal que costuma resolver |
|---|---|---|
| Site institucional | www e sem www, HTTP e HTTPS, barra final | Redirecionamento 301 para uma versão única |
| Loja virtual | Filtros, ordenação, variações de produto | rel="canonical" para a categoria ou produto principal |
| Blog e portal | Parâmetros de campanha, páginas de tag e de autor | Canonical para si mesma em cada artigo e links internos limpos |
| Site em vários idiomas | Versões por país com texto quase igual | Canonical no mesmo idioma e hreflang ligando as versões |
| Site em JavaScript | Rotas geradas no navegador e canônica trocada por script | Canonical no HTML de origem, sem alteração por script |
| Documentos e PDFs | O mesmo arquivo em mais de um endereço | Cabeçalho HTTP Link com rel="canonical" |
Leitura da Alliance Comunicação a partir da documentação do Google sobre canonicalização.
Na loja, o volume muda a natureza do problema: são milhares de combinações de filtro, e cada uma consome rastreamento. O artigo sobre o filtro de cor e tamanho que gasta o rastreamento trata desse caso com mais detalhe.
Por onde começar hoje
- Escolha a versão oficial do domínio (com ou sem www, sempre HTTPS) e redirecione as outras com 301.
- Confira se cada página importante tem rel="canonical" no <head>, com URL absoluta e apontando para si mesma.
- Compare o sitemap com as canônicas: ele deve listar só elas, sem variação.
- Revise os links do menu, do rodapé e do corpo para que apontem para a URL canônica, não para a variação.
- No Search Console, abra os três status de cópia e inspecione uma amostra de URLs de cada um.
- Onde houver divergência, alinhe os sinais primeiro e só depois mexa na tag.
- Repita a conferência depois de toda mudança de plataforma, tema ou estrutura de URL.
Se a dúvida é anterior, se o problema do site é técnico, de conteúdo ou de autoridade, o diagnóstico de marketing gratuito da Alliance leva cerca de 30 minutos e mostra em que frente agir primeiro. Quando o caso pedir mão na obra, a agência de SEO da Alliance em São Paulo audita rastreamento, indexação e canônicas, corrige os sinais junto com o time de desenvolvimento e acompanha o relatório de indexação até a versão certa ficar no índice, com 16 anos de mercado e mais de 300 projetos na bagagem.