O robots.txt é o arquivo mais curto do site e um dos mais perigosos. Uma linha errada pode esconder o catálogo inteiro do Google, e uma linha certa no lugar errado pode manter na busca justamente a página que você queria apagar. Quase sempre ele foi escrito por quem montou o site, por um plugin ou pela hospedagem, e nunca mais foi aberto.
Este guia explica o que é o robots.txt, como escrever as regras e como testar o arquivo. E vai além da sintaxe que os tutoriais ensinam: mostra por que o Disallow não tira uma página do Google, o que acontece quando o próprio arquivo dá erro, por que a correção não vale na hora e quais campos populares o Google simplesmente não lê. No fim, um checklist de auditoria de dez minutos.
O que é robots.txt?
Robots.txt é um arquivo de texto simples, publicado na raiz do domínio (por exemplo, seusite.com.br/robots.txt), que diz aos rastreadores quais caminhos do site eles podem visitar. Ele segue o Protocolo de Exclusão de Robôs e é a primeira coisa que um robô educado consulta antes de começar a ler as páginas.
A palavra-chave aqui é rastrear. O arquivo pede ao robô que não entre em certos endereços; ele não decide o que aparece nos resultados. Segundo a introdução ao robots.txt do Google Search Central, o uso principal é evitar que o site seja sobrecarregado com solicitações, e não manter páginas fora da busca.
Outro ponto que costuma passar despercebido: o robots.txt é um pedido, não uma tranca. Os robôs dos grandes buscadores respeitam as regras, mas nada impede um rastreador mal-intencionado de ignorá-las. E, como o arquivo é público, qualquer pessoa pode lê-lo. Listar ali o endereço de uma área sensível é, na prática, anunciar onde ela está.
Para que serve o robots.txt e quando não usar?
O robots.txt é uma ferramenta de gestão de rastreamento. Ele faz sentido quando o site gera muitos endereços que não têm valor para a busca e que consomem o tempo do robô. Os usos legítimos mais comuns:
- Busca interna e filtros: páginas de resultado de busca do próprio site e combinações de filtros de loja, que geram milhares de URLs quase iguais.
- Áreas administrativas e de carrinho: caminhos como o painel do CMS ou o checkout, que não fazem sentido no Google.
- Arquivos de mídia específicos: imagens, vídeos ou áudios que você não quer que apareçam nos resultados do Google.
- Declarar o sitemap: a linha
Sitemap:aponta o mapa do site para todos os robôs de uma vez.
E há três situações em que ele é a ferramenta errada. Para tirar uma página da busca, o caminho é o noindex. Para proteger informação confidencial, o caminho é senha ou bloqueio no servidor. Para reduzir a velocidade do robô, o Google não lê o campo que muita gente usa para isso, como você vai ver adiante.
Qual a diferença entre robots.txt e noindex?
Os dois aparecem juntos em quase todo guia de SEO técnico e são confundidos o tempo todo. A diferença é de etapa: o robots.txt atua antes de o robô entrar na página; o noindex atua depois que ele entrou e leu o código. Um controla a porta; o outro, a vitrine.
| Robots.txt (Disallow) | Noindex (meta tag ou cabeçalho) | |
|---|---|---|
| O que controla | Rastreamento: se o robô pode visitar o endereço | Indexação: se a página pode aparecer nos resultados |
| Onde fica | Um arquivo único na raiz do domínio | Em cada página (meta robots) ou no cabeçalho HTTP X-Robots-Tag |
| Alcance | Pastas, padrões de URL, tipos de arquivo | Página por página, ou por tipo de arquivo via cabeçalho |
| Tira a página do Google? | Não. A URL pode aparecer sem descrição | Sim, desde que o robô consiga ler a página |
| Melhor uso | Poupar rastreamento de áreas sem valor | Manter fora da busca páginas que existem e são acessíveis |
Google Search Central: Introdução ao robots.txt e Bloquear a indexação com noindex (atualizadas em dez/2025)
Por que o Disallow não tira a página do Google?
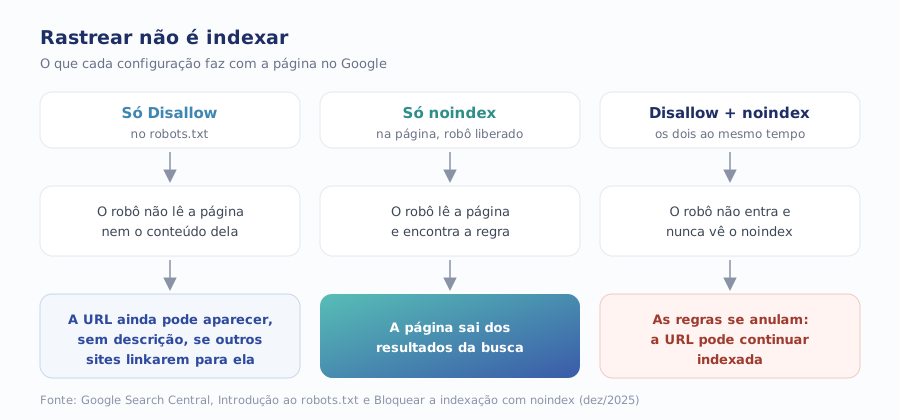
Porque o Google não precisa visitar uma página para saber que ela existe. Se outros sites ou outras páginas do seu domínio apontam para um endereço, o buscador conhece a URL pelos links, mesmo sem nunca ter lido o conteúdo.
O resultado é aquela linha estranha na busca: o endereço aparece, mas no lugar do resumo vem um aviso de que não há informação disponível sobre a página. Para quem queria esconder uma página de preços antiga, uma área de clientes ou uma campanha encerrada, é o pior dos mundos: a página continua lá, só que com cara de abandonada.
O erro que agrava isso é o mais caro do robots.txt: bloquear no arquivo uma página que tem noindex. A lógica parece reforçar a proteção, mas faz o contrário.
A ordem correta para tirar uma página do Google é: deixar a página liberada no robots.txt, colocar o noindex, esperar o robô passar e confirmar a saída no Search Console. Só depois disso, se fizer sentido poupar rastreamento, o bloqueio no robots.txt pode entrar.
O robots.txt fecha a porta; o noindex apaga a vitrine. Fechar a porta antes impede o robô de ver o aviso de que a vitrine acabou.
Como funciona a sintaxe do robots.txt?
O arquivo é formado por grupos. Cada grupo começa com uma ou mais linhas User-agent, que dizem a qual robô as regras se aplicam, seguidas das linhas Disallow e Allow. A especificação do Google sobre o robots.txt, atualizada em 12/09/2026, aceita só quatro campos: user-agent, allow, disallow e sitemap.
1. User-agent: para quem é a regra
User-agent: * vale para todos os robôs. User-agent: Googlebot vale só para o robô de busca do Google. Pela especificação, cada robô obedece a um único grupo: o que tem o nome mais específico para ele. Se existe um grupo para Googlebot, o Googlebot ignora o grupo do asterisco, e as regras dos dois não se somam. A ordem dos grupos no arquivo não importa.
2. Disallow e Allow: o que pode e o que não pode
Disallow: /admin/ pede que o robô não visite nada que comece com /admin/. Allow abre uma exceção dentro de uma área bloqueada. Os caminhos começam sempre com barra e diferenciam maiúsculas de minúsculas: /Blog/ e /blog/ são endereços diferentes para o robô.
Quando Allow e Disallow batem na mesma URL, vence a regra mais específica, ou seja, a de caminho mais longo. Em empate, vence a menos restritiva, o Allow. Por isso Disallow: /loja/ combinado com Allow: /loja/ofertas/ libera só a pasta de ofertas.
3. Curingas: asterisco e cifrão
O asterisco (*) representa qualquer sequência de caracteres, e o cifrão ($) marca o fim da URL. Disallow: /*?filtro= bloqueia qualquer endereço com esse parâmetro; Disallow: /*.pdf$ bloqueia os endereços que terminam em .pdf. Curinga mal escrito é a causa mais comum de bloqueio acidental de páginas importantes.
4. Sitemap: o mapa para todos os robôs
A linha Sitemap: não pertence a nenhum grupo e vale para todos os robôs. Ela precisa trazer a URL completa, com protocolo e domínio, e pode haver várias. O Google aceita até que o sitemap esteja em outro domínio. Se quiser entender o que vai dentro desse arquivo, veja o nosso guia sobre as tags do sitemap XML que o Google ignora.
Como usar o robots.txt na prática?
Os quatro modelos abaixo cobrem a maioria dos pedidos de quem busca por robots.txt. Cada linha vai sozinha no arquivo, na ordem mostrada.
1. Liberar tudo (allow all)
User-agent: *Disallow:
Um Disallow vazio não bloqueia nada. O efeito é o mesmo de não ter arquivo, mas deixar o arquivo publicado evita que o servidor responda com erro quando o robô o procurar.
2. Bloquear todo o site
User-agent: *Disallow: /
A barra sozinha cobre todos os endereços. É o padrão de ambiente de homologação, e é justamente por isso que aparece por engano em tantos sites recém-lançados: o arquivo de teste vai para o ar junto com o site novo.
3. Bloquear uma pasta com exceção
User-agent: *Disallow: /area-do-cliente/Allow: /area-do-cliente/cadastro
O Allow mais longo libera só a página de cadastro dentro da área bloqueada.
4. Declarar o sitemap
Sitemap: https://www.seusite.com.br/sitemap.xml
Pode ficar no início ou no fim do arquivo. Lembre que ele não substitui o envio do sitemap no Search Console; os dois se complementam.
O que o Google faz quando o robots.txt dá erro?
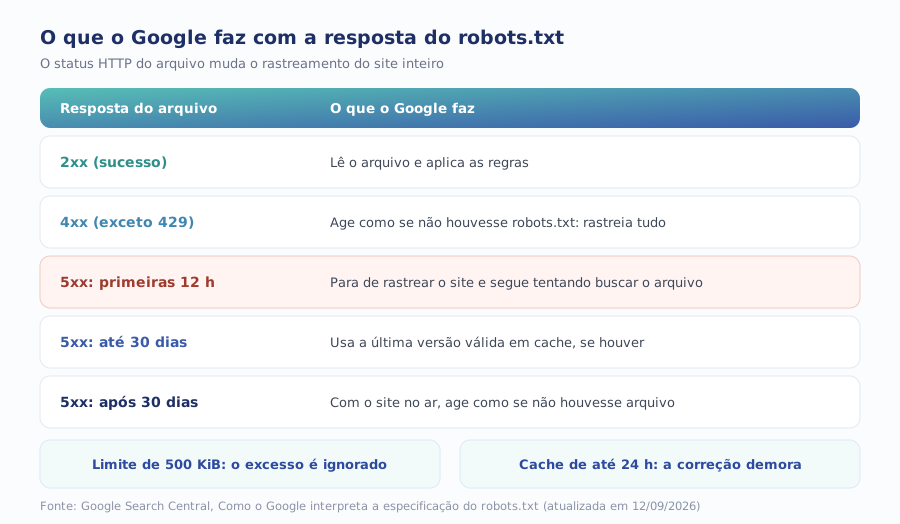
Esta é a parte que os tutoriais mais lidos pulam, e a que mais derruba site na prática. O Google não trata o robots.txt só pelo conteúdo: o código de resposta HTTP do próprio arquivo muda o comportamento do robô no site inteiro.
| Resposta do robots.txt | O que o Google faz | Risco |
|---|---|---|
| 2xx (sucesso) | Lê o arquivo e aplica as regras | Só o das regras escritas |
| 4xx, exceto 429 | Age como se não houvesse robots.txt válido: rastreia sem restrição | Áreas que você queria poupar passam a ser rastreadas |
| 5xx ou servidor inacessível, primeiras 12 horas | Para de rastrear o site e continua tentando buscar o arquivo | Páginas novas e atualizadas deixam de ser lidas |
| 5xx por até 30 dias | Usa a última versão válida em cache; sem cache, assume que não há restrição | O site fica preso a regras antigas |
| 5xx por mais de 30 dias, site no ar | Age como se não houvesse robots.txt | Regras de bloqueio deixam de valer |
Google Search Central, Como o Google interpreta a especificação do robots.txt (atualizada em 12/09/2026)
A linha que mais assusta é a do 5xx. Um servidor instável, um firewall que bloqueia o robô ou uma regra de CDN que devolve erro só para o arquivo robots.txt podem parar o rastreamento do site inteiro, mesmo com todas as páginas funcionando para o visitante. O sintoma aparece dias depois, quando páginas novas não entram no índice e ninguém liga uma coisa à outra.
A especificação também deixa claro que os códigos 401 e 403 não devem ser usados para limitar a velocidade de rastreamento: para o Google, eles entram na regra dos 4xx e significam acesso livre. O 429 é a exceção explícita a essa regra.
Que outras regras do Google quase ninguém conhece?
Além do status HTTP, a especificação traz detalhes operacionais que explicam boa parte dos problemas que aparecem em auditoria técnica:
- Limite de 500 KiB. O Google lê até 500 KiB do arquivo e ignora o resto. Robots.txt gigante, gerado por plugin com milhares de linhas, pode ter as últimas regras simplesmente descartadas.
- Cache de até 24 horas. O Google costuma guardar o arquivo em cache por até um dia, e por mais tempo se a atualização falhar. Corrigiu um bloqueio errado? O efeito não é imediato.
- Crawl-delay não vale para o Google. O campo é ensinado em muitos guias, mas a especificação lista só user-agent, allow, disallow e sitemap como compatíveis.
- Um arquivo por host. Cada subdomínio, protocolo e porta não padrão precisa do próprio robots.txt. O arquivo de
wwwnão vale paraloja.nem parablog.. - Arquivo em subpasta é ignorado. Só o da raiz conta. Um robots.txt em /blog/robots.txt não tem efeito nenhum.
- Redirecionamentos têm limite. O Google segue pelo menos cinco saltos de redirecionamento; depois disso, trata o arquivo como 404, ou seja, sem restrição.
- Formato UTF-8. O arquivo precisa ser texto simples em UTF-8. Linhas inválidas são ignoradas sem aviso.
Como bloquear bots de IA no robots.txt?
Os robôs de empresas de IA também leem o robots.txt e são bloqueados pelo mesmo mecanismo: um grupo User-agent com o nome do robô e um Disallow: /. A decisão, porém, não é técnica, é estratégica. Bloquear o robô errado pode tirar a marca das respostas que os clientes leem.
Cada empresa costuma separar robôs de busca e robôs de treino, e as consequências são diferentes. No caso da OpenAI, por exemplo, bloquear o robô de busca tira o site das respostas do ChatGPT, enquanto bloquear o de treino não tem esse efeito. O passo a passo está no nosso artigo sobre o robô que o site bloqueia e tira a marca do ChatGPT.
Uma regra vale para todos esses robôs: o grupo do asterisco não se soma ao grupo nomeado. Se você criar um grupo específico para um robô de IA, ele passa a ignorar todas as regras gerais do arquivo, e as que valerem para ele precisam ser repetidas ali dentro.
Quais os erros mais comuns no robots.txt?
- Publicar o arquivo de homologação. O
Disallow: /do ambiente de teste vai para o ar com o site novo e esconde tudo. - Bloquear página com noindex. O robô nunca lê a regra, e a página continua no índice.
- Usar Disallow para tirar página do Google. A URL fica na busca, sem descrição.
- Bloquear CSS e JavaScript. Se o robô não consegue carregar esses recursos, pode não entender a página como o visitante a vê.
- Confiar no crawl-delay. O Google não lê esse campo.
- Esquecer os subdomínios. Cada um precisa do próprio arquivo.
- Ignorar o status do arquivo. Um robots.txt que responde 5xx pausa o rastreamento do site inteiro.
- Escrever caminho com maiúscula errada.
/Produtos/não bloqueia/produtos/. - Listar áreas secretas no arquivo. O robots.txt é público e funciona como mapa para quem procura.
Como testar o robots.txt?
Há três camadas de teste, da mais simples à mais completa. A primeira é abrir o arquivo no navegador e ler. A segunda é conferir o código de resposta: ferramentas de inspeção do navegador ou qualquer verificador de cabeçalho HTTP mostram se o arquivo responde 200 ou outro código.
A terceira é o Google Search Console. O relatório de robots.txt mostra quais arquivos o Google encontrou para cada host, quando foram lidos pela última vez e se houve erro ou aviso. A ferramenta de inspeção de URL informa se um endereço específico está bloqueado. Para quem nunca explorou esse painel a fundo, o nosso guia sobre o que os relatórios do Search Console não mostram ajuda a ler os números com cuidado.
Lembre do cache: depois de corrigir o arquivo, o Google pode levar até um dia para usar a versão nova. O Search Console permite pedir uma nova leitura quando a correção é urgente.
O que muda por tipo de site?
| Tipo de site | O que costuma valer a pena bloquear | Cuidado principal |
|---|---|---|
| Site institucional pequeno | Quase nada; o arquivo serve para declarar o sitemap | Não publicar o arquivo de homologação |
| Loja virtual | Filtros, ordenações, busca interna, carrinho e checkout | Curinga que bloqueia página de produto por engano |
| Blog e portal | Busca interna e páginas de tag sem conteúdo próprio | Não bloquear imagens e recursos dos artigos |
| SaaS ou área logada | Painel e páginas do aplicativo | Área logada se protege com senha, não com robots.txt |
| Empresa com vários subdomínios | Varia por subdomínio | Cada host precisa do próprio arquivo |
Elaborado pela Alliance a partir da documentação do Google Search Central
Em plataformas prontas, como Wix, WordPress com plugin de SEO ou lojas em SaaS, o arquivo costuma ser gerado automaticamente e editado pelo painel de configurações de SEO. Vale abrir e ler mesmo assim: o padrão da plataforma nem sempre combina com a estrutura do seu site.
Por onde começar: auditoria de 10 minutos
Este checklist cobre os problemas que mais aparecem na prática. Se algum item falhar, ele já indica o que corrigir:
- Abra
/robots.txtem cada host do site (www, sem www, subdomínios). - Confirme que o arquivo responde 200, e não 4xx, 5xx ou um redirecionamento em cadeia.
- Procure
Disallow: /sobUser-agent: *ou sobGooglebot. - Liste as páginas com noindex e confira se nenhuma está bloqueada no arquivo.
- Verifique se CSS, JavaScript e imagens das páginas importantes estão liberados.
- Apague linhas de crawl-delay que você imaginava valerem para o Google, ou saiba que elas não têm efeito ali.
- Confirme que a linha
Sitemap:tem a URL completa e que o endereço abre. - Revise os grupos de robôs de IA com a decisão de negócio em mente: busca e treino são escolhas diferentes.
- Abra o relatório de robots.txt no Search Console e veja se há erro de leitura recente.
O robots.txt é só a primeira camada do SEO técnico, mas é a que mais causa estrago silencioso. Se quiser uma leitura completa de como o seu site é rastreado, indexado e citado pelas IAs, conheça o nosso trabalho de SEO e GEO ou comece pelo diagnóstico de marketing gratuito, que aponta as prioridades do seu negócio em poucos minutos.