Quase todo conselho sobre como aparecer no ChatGPT começa pelo conteúdo: escrever respostas diretas, usar dados, ganhar menções na imprensa. Tudo isso conta. Mas existe uma pergunta anterior, que quase ninguém faz, e que pode anular o resto: o robô que alimenta a busca do ChatGPT consegue entrar no seu site?
Muita empresa nunca abriu o próprio robots.txt. Ele foi montado por quem fez o site, por um plugin ou por um padrão da hospedagem, e ninguém sabe dizer o que está liberado. Este guia faz a auditoria desse passo zero, com base na documentação oficial da OpenAI: quais são os robôs, o que cada bloqueio causa, como decidir entre aparecer na busca e ceder conteúdo para treino, e só então o que fazer com o conteúdo.
O que é preciso para aparecer no ChatGPT?
Para uma página ser citada nas respostas da busca do ChatGPT, duas condições precisam estar de pé. A primeira é técnica: o robô de busca da OpenAI, o OAI-SearchBot, tem de conseguir ler a página. A segunda é editorial: entre as páginas que ele leu, a sua precisa ser a que responde melhor à pergunta.
A segunda condição é a que ocupa quase todos os artigos sobre o tema. A primeira é binária e silenciosa. Se o robô estiver barrado, não importa a qualidade do texto: a página não entra nas respostas da busca. E nada no painel do site avisa que isso está acontecendo.
Repare na ressalva do final. Bloquear o OAI-SearchBot não apaga a empresa do ChatGPT por completo: o nome ainda pode surgir como link de navegação, aquele atalho para quem procura o site pelo nome. O que some é a citação dentro da resposta, que é justamente onde se disputa a atenção de quem ainda não conhece a marca.
Quais são os robôs da OpenAI e o que cada um faz?
A OpenAI usa mais de um robô, e cada um tem uma função diferente. Tratar todos como “o robô do ChatGPT” é a origem da maioria das decisões erradas no robots.txt. A documentação oficial descreve três:
| OAI-SearchBot | GPTBot | ChatGPT-User | |
|---|---|---|---|
| Para que serve | Mostrar sites nas respostas da busca do ChatGPT | Coletar conteúdo que pode ser usado no treino dos modelos de IA generativa | Visitar uma página quando um usuário pede algo no ChatGPT ou num GPT personalizado |
| Rastreia a web por conta própria? | Sim | Sim | Não: age a partir de uma ação do usuário |
| Obedece ao robots.txt? | Sim, é por ele que se controla a busca | Sim, é por ele que se recusa o treino | Pode não obedecer, porque a ação parte do usuário |
| O que acontece se bloquear | O site sai das respostas da busca; pode sobrar como link de navegação | Sinaliza que o conteúdo não deve ser usado no treino | Não muda quem aparece na busca |
| Trecho que identifica no registro do servidor | OAI-SearchBot | GPTBot | ChatGPT-User |
Elaborado pela Alliance Comunicação a partir de OpenAI, “Overview of OpenAI Crawlers” (2026).
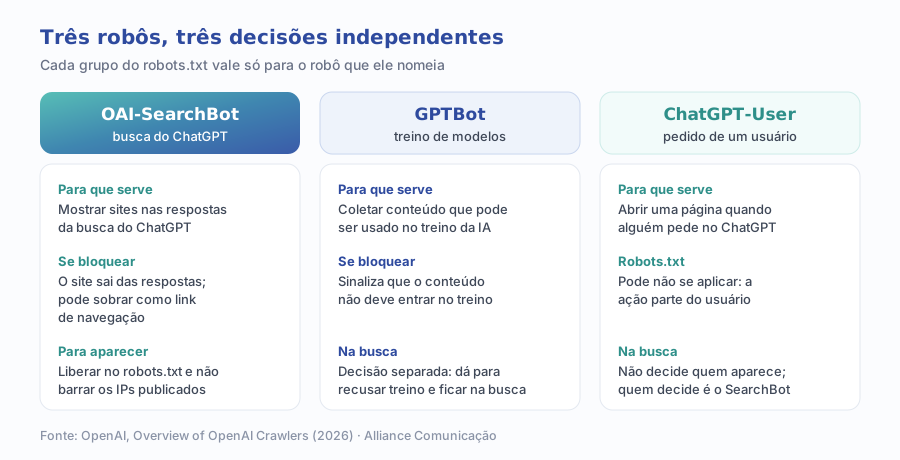
Os nomes que aparecem na tabela são os que vão no robots.txt e os que aparecem no registro de acessos do servidor. A OpenAI também publica a lista de endereços IP de cada robô, o que permite conferir se um acesso que se diz OAI-SearchBot vem mesmo da empresa (a lista da busca fica em openai.com/searchbot.json).
O que acontece se o site bloquear o OAI-SearchBot?
O efeito prático é ficar de fora da parte do ChatGPT que mais se parece com um buscador. Quando alguém pergunta “qual empresa faz tal serviço em São Paulo” ou “como resolver tal problema”, a busca do ChatGPT monta a resposta citando páginas. Site bloqueado não está entre as candidatas.
O bloqueio raramente é uma decisão consciente. Há três cenários típicos:
- Bloqueio geral herdado. Um
Disallow: /no grupo do asterisco, colocado na época em que o site estava em construção e nunca retirado. Ele vale para todo robô que não tenha grupo próprio, inclusive o OAI-SearchBot. - Bloqueio “anti-IA” em pacote. Alguém leu que era preciso proteger o conteúdo das IAs e copiou uma lista pronta de robôs para bloquear. A lista trazia o GPTBot, que é de treino, e o OAI-SearchBot, que é de busca. A empresa quis recusar o treino e saiu da vitrine junto.
- Bloqueio fora do robots.txt. O arquivo libera tudo, mas o firewall, a CDN ou um plugin de segurança recusa o acesso antes. Do lado de fora, o efeito é o mesmo.
Nos três casos o site continua funcionando para o visitante humano, o Google continua indexando, e ninguém percebe nada. A ausência só aparece quando alguém testa o ChatGPT perguntando pelo próprio mercado e nota que o concorrente é citado e a sua empresa não.
Qual a diferença entre OAI-SearchBot e GPTBot?
O OAI-SearchBot existe para a busca: ele lê páginas para que o ChatGPT possa citá-las ao responder. O GPTBot existe para o treino: ele coleta conteúdo que pode ser usado para treinar os modelos de IA generativa da OpenAI. São finalidades diferentes, controladas por grupos diferentes no robots.txt, e a OpenAI deixa explícito que uma decisão não depende da outra.
Isso abre quatro combinações possíveis, e cada uma é uma decisão de negócio, não de TI:
| Combinação | Busca do ChatGPT | Treino de modelos | Para quem costuma fazer sentido |
|---|---|---|---|
| Libera os dois | Pode ser citado | Conteúdo pode ser usado | Quem quer o máximo de presença e não vê risco em ceder o texto |
| Libera busca, recusa treino | Pode ser citado | Sinaliza recusa | Quem quer ser encontrado, mas considera o conteúdo um ativo próprio |
| Recusa busca, libera treino | Fica de fora das respostas | Conteúdo pode ser usado | Raramente faz sentido: cede o texto sem ganhar a vitrine |
| Recusa os dois | Fica de fora das respostas | Sinaliza recusa | Quem vende o próprio conteúdo (editoras, cursos pagos) e tem outra estratégia de aquisição |
Elaborado pela Alliance Comunicação a partir de OpenAI, “Overview of OpenAI Crawlers” (2026).
A documentação traz um detalhe útil para quem libera os dois: se o site permitir ambos os robôs, a OpenAI pode usar o resultado de um único rastreamento para as duas finalidades, para não visitar o site em dobro. Ou seja, liberar os dois não significa receber o dobro de acessos.
OAI-SearchBot vs ChatGPT-User: o que muda?
O ChatGPT-User não é um rastreador no sentido clássico. Ele aparece quando uma pessoa, dentro do ChatGPT ou de um GPT personalizado, pede algo que exige abrir uma página: “leia este link”, “veja o que diz o site tal”. A visita acontece porque alguém pediu, e não porque um robô saiu varrendo a web.
Duas consequências práticas saem daí. A primeira: ver o ChatGPT-User no registro do servidor não prova que o site está liberado para a busca, porque ele não decide isso. A segunda: bloquear o ChatGPT-User no robots.txt não é um jeito confiável de impedir que um usuário peça ao ChatGPT para ler uma página pública. Quem precisa proteger conteúdo de verdade precisa de login ou de controle de acesso, e não de um pedido no robots.txt.
Esse ponto vale para o arquivo inteiro, aliás. O padrão que define o robots.txt, a RFC 9309, afirma que as regras não são uma forma de autorização de acesso: são pedidos que os rastreadores são solicitados a respeitar.
Como saber se o seu site está bloqueando o ChatGPT?
A auditoria cabe em uma tarde e não exige ferramenta paga. São quatro passos, nesta ordem.
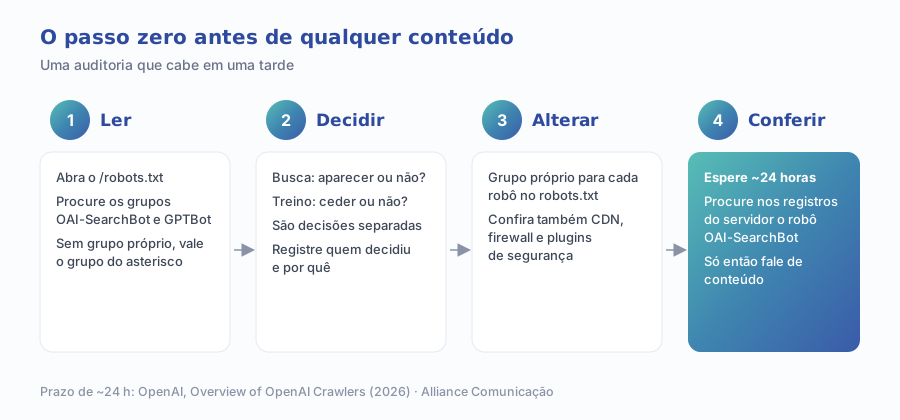
1. Leia o robots.txt como ele está hoje
Abra no navegador o endereço do site seguido de /robots.txt. Pela RFC 9309, é nesse caminho, na raiz, que o arquivo precisa estar. Procure três coisas: um grupo que comece com User-agent: OAI-SearchBot, um com User-agent: GPTBot e o grupo User-agent: *, o asterisco, que vale para qualquer robô sem grupo próprio.
A regra de leitura que confunde muita gente: pela RFC 9309, o rastreador procura o grupo com o próprio nome e obedece às regras dele; só se não existir grupo com o nome dele é que vale o grupo do asterisco. Então um Disallow: / no asterisco bloqueia o OAI-SearchBot se ele não tiver grupo próprio, e não bloqueia se tiver.
2. Decida busca e treino separadamente
Antes de editar qualquer linha, responda por escrito duas perguntas: a empresa quer ser citada nas respostas da busca do ChatGPT? E aceita que o conteúdo público seja usado no treino de modelos? Registre quem decidiu e por quê. Essa decisão deveria envolver marketing, jurídico e diretoria, e não ficar a cargo de quem por acaso tem a senha da hospedagem.
3. Altere o arquivo e o que fica na frente dele
Escreva um grupo próprio para cada robô, de acordo com a decisão. Para “busca sim, treino não”, o trecho fica assim:
User-agent: OAI-SearchBotAllow: /User-agent: GPTBotDisallow: /
Depois, confira o que fica antes do arquivo: CDN, firewall de aplicação e plugins de segurança. A documentação da OpenAI recomenda, além de liberar o OAI-SearchBot no robots.txt, permitir as requisições vindas dos IPs que ela publica. Uma regra de firewall que barra esses endereços desfaz o que o robots.txt liberou.
4. Espere e confira no registro do servidor
Passado esse prazo, peça a quem cuida da hospedagem os registros de acesso e procure o trecho OAI-SearchBot no agente de usuário. Se ele aparece e recebe resposta normal, o caminho está aberto. Se ele aparece e recebe recusa, o bloqueio está em alguma camada antes do site. Se ele não aparece nunca, vale conferir de novo o arquivo e as regras de firewall.
Onde o bloqueio se esconde além do robots.txt?
O robots.txt é o lugar óbvio, mas não é o único. Serviços de infraestrutura que ficam na frente do site também podem bloquear robôs de IA, e há caso de bloqueio adotado como padrão.
O anúncio não diz, sozinho, quais robôs são afetados em cada conta, e as opções do painel mudam com o tempo. A lição é outra: se o site passa por uma CDN ou um serviço de proteção, existe a possibilidade de um bloqueio de robôs de IA ativo ali, independentemente do que diz o robots.txt. Quem administra o serviço precisa abrir o painel e conferir se a regra trata o robô de busca e o de treino da mesma forma.
O mesmo vale para plugins de segurança e para hospedagens com proteção própria contra robôs. A pergunta a fazer a cada fornecedor é simples: “existe alguma regra que bloqueie o OAI-SearchBot ou os IPs publicados pela OpenAI?”.
Como configurar o OAI-SearchBot no WordPress?
No WordPress, o robots.txt costuma ser gerado pelo próprio sistema. A função que monta o arquivo padrão, documentada em developer.wordpress.org, escreve apenas um grupo para o asterisco, que bloqueia a área administrativa e libera um endereço técnico dela. Nesse padrão, não há nada contra o OAI-SearchBot.
O problema costuma vir de fora do núcleo. A mesma função tem um filtro que permite a plugins acrescentar ou trocar linhas do arquivo, e é por aí que plugins de SEO, de segurança ou de “proteção contra IA” inserem bloqueios. Por isso, no WordPress, a auditoria tem um passo a mais: depois de ler o arquivo publicado, descubra qual plugin está escrevendo cada grupo, e faça a mudança nele. Editar à mão sem saber quem gera o arquivo é a receita para a regra voltar na próxima atualização.
Depois de liberar o robô, o que faz a empresa ser citada?
Liberar o OAI-SearchBot é condição, não garantia. A partir daí, a disputa é editorial, e os princípios são os mesmos que valem para a busca com IA em geral: responder a pergunta logo no início da página, sustentar afirmações com dados e fontes, deixar claro quem é a empresa e o que ela faz, e ter páginas que tratem de um assunto por vez.
Esses princípios já estão detalhados em outros guias do blog. Para o lado do Google, que tem regras próprias e publicadas, veja o que o Google realmente exige para aparecer na IA. Para a dúvida frequente sobre o arquivo que supostamente “ensina” as IAs a ler o site, veja para que serve o llms.txt, e o que ele não faz. E, quando a IA cita a empresa com informação errada, o problema muda de natureza: por que o assistente inventa sobre a sua empresa.
O que este artigo acrescenta é a ordem. Investir em conteúdo para ser citado no ChatGPT antes de confirmar que o robô de busca entra no site é como fazer vitrine numa loja de porta trancada.
Quais são os erros mais comuns?
- Bloquear “todos os robôs de IA” com uma lista copiada. A lista mistura busca e treino. A empresa queria recusar só o treino e sumiu da busca.
- Achar que bloquear o GPTBot tira o site do ChatGPT. O GPTBot trata de treino. A presença na busca é decidida pelo OAI-SearchBot.
- Confiar no ChatGPT-User como prova. Ver acessos dele no registro não mostra que o site está liberado para a busca, porque ele não decide isso.
- Esquecer o grupo do asterisco. Sem grupo próprio, o OAI-SearchBot obedece ao asterisco. Um
Disallow: /esquecido ali vale para ele. - Mudar o arquivo e testar no mesmo minuto. A OpenAI fala em cerca de 24 horas para os sistemas de busca se ajustarem.
- Olhar só o robots.txt. CDN, firewall e plugins de segurança podem barrar o robô antes de ele chegar ao arquivo.
- Tratar o robots.txt como cadeado. Ele é um pedido. Conteúdo que não pode circular precisa de controle de acesso de verdade.
Como medir se o ChatGPT está lendo e trazendo visitas?
A medição tem duas camadas. A primeira é a leitura: os registros de acesso do servidor mostram se o OAI-SearchBot está visitando o site, quais páginas ele lê e com que frequência. É a prova técnica de que o passo zero funcionou. Para separar o robô verdadeiro de um impostor que usa o mesmo nome, compare o IP de origem com a lista que a OpenAI publica.
A segunda camada é a visita humana: pessoas que leram uma resposta do ChatGPT e clicaram no link citado. No relatório de origens do seu analytics, vale criar um recorte para os acessos que chegam com o ChatGPT como origem. Mais do que o número absoluto, acompanhe a tendência e as páginas de entrada: elas mostram quais conteúdos a IA está escolhendo citar.
Uma terceira verificação, manual, completa o quadro: perguntar ao próprio ChatGPT, pedindo que ele busque na web, as perguntas que um cliente faria sobre o seu mercado, e anotar quem é citado. Repetida todo mês com as mesmas perguntas, essa lista vira um termômetro simples da presença da marca.
Por onde começar hoje?
A sequência é curta. Abra o robots.txt e leia os grupos. Leve à diretoria as duas perguntas, busca e treino, e registre a resposta. Ajuste o arquivo e confira CDN, firewall e plugins. Espere cerca de um dia e procure o OAI-SearchBot nos registros. Só então entre na fila do conteúdo.
Se a sua empresa quer apoio para fazer essa auditoria e, depois dela, montar o conteúdo que a IA cita, esse é o trabalho do nosso serviço de SEO e GEO para buscadores e IAs. E se ainda não está claro se a presença digital é a prioridade do momento, o diagnóstico gratuito de marketing avalia presença digital, conteúdo e dados e devolve as frentes em ordem de prioridade.
Para quem quiser ler a fonte, a OpenAI mantém uma página de perguntas frequentes para publicadores e desenvolvedores, em português, além da documentação técnica dos robôs citada ao longo deste texto.