Todo guia de teste A/B ensina a mesma coisa: escolha um elemento, crie uma versão B, divida o tráfego, espere o resultado e fique com a vencedora. Está certo. O que quase nenhum deles diz é quanto tempo é "esperar" — e é justamente essa resposta que separa um teste que decide alguma coisa de um sorteio com gráfico bonito.
Este artigo faz a conta que falta, com a documentação das próprias plataformas de experimento: quantos visitantes cada versão precisa, quantas semanas isso dá com o tráfego que você tem, por que olhar o resultado todo dia engana e o que fazer quando a página simplesmente não tem volume para testar. No fim, uma régua para decidir se o seu próximo teste deve ou não existir.
O que é teste A/B em marketing?
Teste A/B é um experimento controlado: você mostra, ao mesmo tempo, duas versões de uma mesma peça — página, anúncio, e-mail, formulário — para grupos de pessoas sorteados, e compara qual delas produz mais do resultado que importa. A versão A é o original (o controle); a B é a mudança que você acredita que funciona melhor.
O que dá ao teste o poder de decisão é o sorteio simultâneo. Como os dois grupos vêm do mesmo tráfego, no mesmo período, dia da semana, campanha e clima do mercado pesam igual para os dois lados. A diferença que sobra é, em tese, da mudança — e não de uma segunda-feira boa ou de um feriado.
É isso que o diferencia do "antes e depois", em que se troca a página e compara-se o mês seguinte com o anterior. No antes e depois, tudo mudou junto: a verba, a sazonalidade, a concorrência. No teste A/B, só a peça muda.
Como funciona um teste A/B por dentro?
Por baixo da interface, qualquer ferramenta de experimento faz quatro coisas:
- Sorteia cada visitante para uma das versões e o mantém nela nas visitas seguintes.
- Conta quantos visitantes viram cada versão e quantos realizaram a conversão escolhida (lead, compra, clique no botão).
- Compara as duas taxas e calcula a probabilidade de a diferença observada ser só acaso.
- Declara um vencedor quando essa probabilidade fica baixa o bastante — o limite que se chama significância estatística.
O ponto 3 é onde o tráfego entra. Com poucos visitantes, qualquer diferença pode ser acaso: uma versão com 3 conversões em 100 visitas e outra com 5 em 100 parecem muito diferentes, mas estão dentro do que o sorteio produz sozinho. Só com volume a ferramenta consegue separar o que é efeito do que é ruído.
Há variações do formato. O teste A/B/n compara mais de duas versões; o multivariado testa combinações de vários elementos ao mesmo tempo; o split URL compara duas páginas inteiras em endereços diferentes. Todos seguem a mesma lógica — e todos pedem mais tráfego do que o A/B simples, porque dividem o público em mais partes.
Quanto tráfego um teste A/B precisa?
Esta é a pergunta que decide se o teste vale o esforço antes de ele começar. Um teste sem tráfego suficiente não "demora mais": ele termina sem resposta, ou pior, com uma resposta errada que a equipe implanta com confiança.
Os guias mais lidos sobre o tema tropeçam exatamente aqui. Uns dizem que é "importante determinar o tamanho da amostra" e param. Outros dão prazos — "de 1 a 3 meses", "mínimo de mil" — sem dizer de onde vieram nem para qual situação servem. E há os que usam a fórmula de amostra de pesquisa de opinião (a da margem de erro), que responde outra pergunta: ela estima uma proporção, não compara duas.
A conta certa depende de três números que só você tem: a taxa de conversão atual da página, o tamanho da melhora que você quer ser capaz de enxergar e o tráfego que a página recebe. Com eles, dá para saber em cinco minutos se o teste cabe no seu calendário.
Os dois primeiros estão na documentação da Optimizely, uma das maiores plataformas de experimentação do mercado. O primeiro é a conversão-base, a taxa que a página já tem. O segundo é o efeito mínimo detectável (MDE, na sigla em inglês): a menor melhora que você quer que o teste seja capaz de provar.
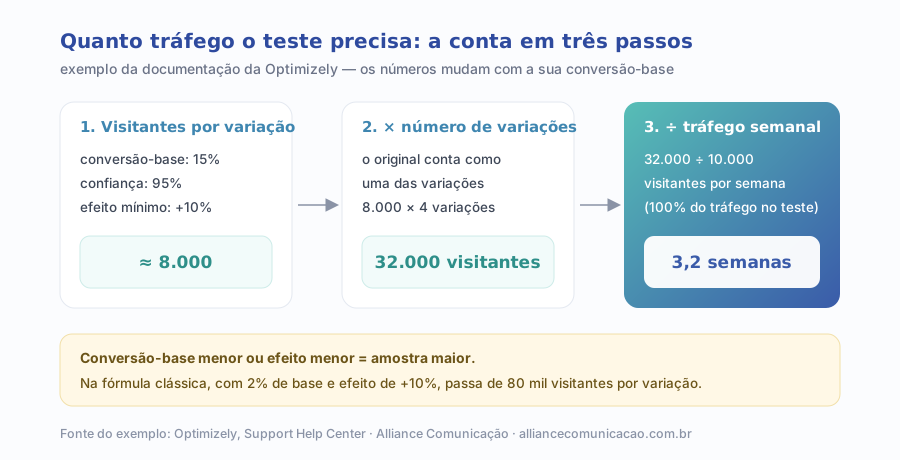
Repare em dois detalhes do exemplo. Primeiro, o original conta como uma das variações: quatro variações são o controle mais três versões novas. Segundo, 15% é uma conversão-base alta — típica de uma etapa intermediária do funil, como a passagem do carrinho para o checkout. Numa landing page de captação ou numa loja virtual, a taxa costuma ser bem menor, e a própria Optimizely avisa que base menor exige amostra maior.
Para mostrar o tamanho desse efeito, refizemos a conta com a fórmula clássica de comparação de duas proporções (95% de confiança, 80% de poder estatístico), para outras bases e outros efeitos. Os números abaixo são visitantes por variação:
| Conversão-base | Efeito de +10% | Efeito de +20% | Efeito de +30% | Efeito de +50% |
|---|---|---|---|---|
| 1% | ≈ 163 mil | ≈ 42,7 mil | ≈ 19,8 mil | ≈ 7,7 mil |
| 2% | ≈ 80,7 mil | ≈ 21,1 mil | ≈ 9,8 mil | ≈ 3,8 mil |
| 5% | ≈ 31,2 mil | ≈ 8,2 mil | ≈ 3,8 mil | ≈ 1,5 mil |
| 15% | ≈ 9,3 mil | ≈ 2,4 mil | ≈ 1,1 mil | ≈ 420 |
Conta da Alliance com a fórmula clássica de horizonte fixo (bicaudal, 95% de confiança, 80% de poder). Efeito = melhora relativa sobre a base. A Optimizely usa estatística sequencial e chega a ~8.000 na linha de 15% com +10%; a ordem de grandeza é a mesma.
A tabela conta a história inteira. Uma página que converte 2% precisa de mais de 80 mil visitantes em cada versão para provar uma melhora de 10% — 160 mil no total. A mesma página prova uma melhora de 50% com menos de 4 mil por versão. Ou seja: o tráfego que você tem define o tamanho da mudança que vale testar.
Uma observação honesta sobre método: plataformas como a Optimizely usam estatística sequencial, desenhada para ser acompanhada durante o teste, e ela mesma alerta que calculadoras de horizonte fixo não estimam bem a duração do seu motor. Os números da tabela servem para planejar a ordem de grandeza, não para prever o dia exato em que a ferramenta vai declarar vencedor.
Quanto tempo deve durar um teste A/B?
A duração sai da conta anterior — visitantes necessários divididos pelo tráfego semanal —, mas tem um piso que não depende do volume: o ciclo do negócio.
O motivo do piso é simples: quem visita na terça-feira de manhã não é quem visita no sábado à noite. Um teste que roda de quarta a sexta mede um público parcial. Por isso a regra prática é rodar em semanas inteiras — 7, 14, 21, 28 dias —, mesmo que a amostra seja alcançada antes.
No outro extremo, prazos muito longos também custam. Quanto mais o teste se estende, mais ele atravessa campanhas, datas sazonais e mudanças no próprio público, e mais visitantes apagam cookies e reaparecem como novos. Na prática da Alliance, se a conta passa de um mês, o sinal é para mudar o teste (testar algo maior, com menos versões), não para esperar mais.
Para experimentos de mídia a referência é outra, e vale conhecer para não misturar. O Google Ads recomenda executar experimentos de campanha por pelo menos 4 a 6 semanas — ou mais, quando o tempo até a conversão é longo, esperando de 1 a 2 ciclos de conversão — e descarta os primeiros 7 dias de dados, para contabilizar o período em que o teste ainda está se ajustando. Essa regra vale para experimentos de campanha, em que o algoritmo de lance precisa aprender; em teste de página, não existe essa fase de aprendizado.
O que é significância estatística — e por que espiar o resultado engana?
Significância estatística é a medida de quanto você pode confiar que a diferença entre as versões não é obra do acaso. Com 95%, aceita-se um risco de 5% de declarar vencedora uma versão que, na verdade, é igual à outra. É o padrão mais comum: o Google Ads, por exemplo, calcula a significância dos experimentos com um teste bicaudal com intervalo de confiança de 95%.
O detalhe que quase ninguém conta está na palavra "espiar". A estatística clássica — a de horizonte fixo, a das calculadoras gratuitas — pressupõe que você define a amostra antes, roda até o fim e olha o resultado uma vez. Se você abre o painel todo dia e para o teste no primeiro dia em que aparecer "significativo", o risco real de falso positivo fica muito acima dos 5% prometidos. Em um teste com dias de sorte e de azar, basta um dia de sorte para a equipe encerrar cedo.
Há duas saídas legítimas. A primeira é disciplina: calcular a amostra antes e só decidir quando ela for atingida, em semanas inteiras. A segunda é usar ferramenta com estatística sequencial, desenhada para ser monitorada continuamente — como o motor da Optimizely. O Google Ads usa um terceiro caminho: segundo a metodologia estatística dos experimentos do Google Ads, os dados são agrupados em vinte blocos de controle e vinte de tratamento e reamostrados pelo método Jackknife antes do teste de significância.
Um teste que você espia todo dia e encerra no primeiro "significativo" não é um teste: é uma aposta que sempre termina quando você está ganhando.
E significância não é tamanho de efeito. Um teste pode ser estatisticamente significativo e mostrar uma melhora pequena demais para pagar a implantação — ou mostrar uma melhora enorme com significância baixa, que é, como a Optimizely descreve, o retrato de amostra insuficiente.
Qual a diferença entre testar página, anúncio e e-mail?
A lógica é a mesma, mas o volume, a métrica e o ambiente mudam. Misturar as regras de um no outro é a origem de muitos prazos sem sentido.
| Página ou landing page | Campanha no Google Ads | ||
|---|---|---|---|
| Onde roda | Ferramenta de experimento no site | Recurso de experimentos do próprio Google Ads | Plataforma de e-mail (envio dividido) |
| Métrica típica | Lead, compra, clique no botão | Conversões, custo por conversão | Abertura, clique, resposta |
| Duração de referência | Semanas inteiras, no mínimo 7 dias (Optimizely) | 4 a 6 semanas, descartando os 7 primeiros dias (Google Ads) | Horas a poucos dias, no envio |
| O que limita | Tráfego da página testada | Volume de conversões da campanha | Tamanho da lista |
| Cuidado principal | Não espiar e encerrar cedo | Fase de aprendizado do lance | Não generalizar para outro público |
Organizado pela Alliance a partir da documentação da Optimizely e da Central de Ajuda do Google Ads citadas neste artigo
No Meta Ads, o Gerenciador de Anúncios também tem uma função nativa de teste A/B, que divide o público entre as versões para que a mesma pessoa não veja as duas. O raciocínio de volume vale igual: o que limita é o número de conversões que cada versão recebe, não o número de impressões.
E se o site não tem tráfego suficiente?
Então a primeira decisão é aceitar a conta. A maioria das empresas de pequeno e médio porte tem páginas com alguns milhares de visitantes por semana e conversão entre 1% e 5%. Com esse volume, testar a cor do botão é gastar um mês para não descobrir nada.
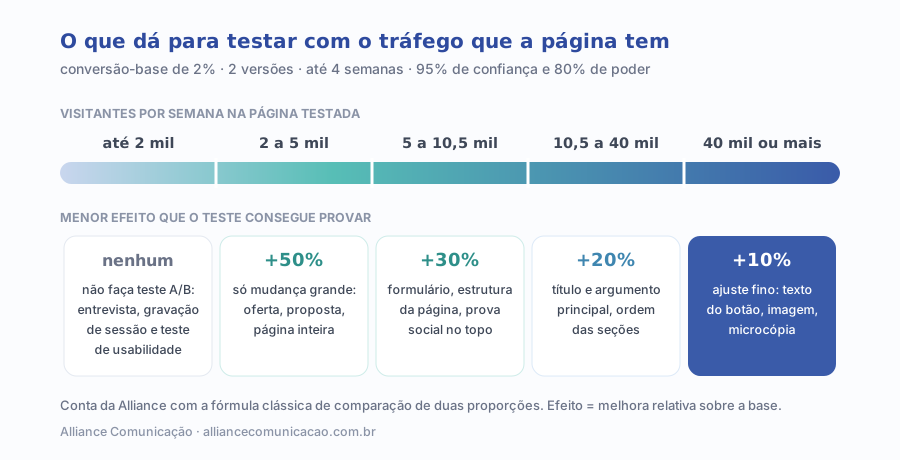
A régua acima sai da mesma conta da tabela, para o caso mais comum: página com 2% de conversão, duas versões e prazo de até quatro semanas. Os exemplos em cada faixa são uma orientação de ordem de grandeza — o que costuma produzir efeito daquele tamanho —, não uma promessa. Com pouco tráfego, há três caminhos:
- Teste mudanças grandes e poucas versões. Em vez de trocar o texto do botão, troque a oferta, a proposta de valor ou a página inteira. Mudança grande produz efeito grande, e efeito grande cabe em amostra pequena. E fique em duas versões: cada versão extra multiplica o tráfego necessário.
- Teste mais acima no funil. O clique no botão acontece muito mais do que o lead preenchido. Uma métrica com conversão-base maior pede menos visitantes — desde que ela realmente leve à conversão final.
- Não teste — use outra evidência. Entrevistas com clientes, gravações de sessão, mapas de calor e testes de usabilidade com cinco ou seis pessoas mostram por que a página não converte. Com pouco tráfego, essa evidência qualitativa vale mais do que um A/B inconclusivo, e a mudança pode ser implantada e acompanhada no antes e depois, com a ressalva de que ele não isola a causa.
Se a dúvida é justamente onde está o gargalo, comece antes do teste: o artigo sobre onde a taxa de conversão vaza no funil mostra como achar a etapa que perde mais gente — e é nela que um teste tem mais chance de mover o resultado.
Como fazer um teste A/B na prática?
O passo a passo abaixo coloca a conta antes da criação — a ordem inversa da que a maioria segue.
1. Escreva a hipótese com causa e efeito
Não "testar um título novo", mas "se o título disser o prazo de entrega, mais visitantes vão pedir orçamento, porque a dúvida mais ouvida pelo comercial é o prazo". A hipótese amarra a mudança a um motivo, e é esse motivo que você aprende, ganhe ou perca o teste.
2. Escolha uma métrica principal e anote a conversão-base
Uma métrica decide o teste; as outras só acompanham. Tire a conversão-base das últimas quatro semanas no Analytics, da mesma página e do mesmo tipo de tráfego que vai entrar no teste.
3. Calcule a amostra e a duração antes de criar a versão B
Defina o efeito mínimo que valeria a pena implantar, use uma calculadora de amostra e divida pelo tráfego semanal da página. Se passar de um mês, volte ao passo 1 e pense numa mudança maior. Esse é o passo que economiza mais dinheiro — o do teste que não deveria nascer.
4. Crie a variação e confira a mensuração
Antes de ligar, confira se a conversão está sendo registrada nas duas versões, se a versão B carrega na mesma velocidade e se funciona no celular. Uma versão mais lenta perde por ser lenta, não por ser pior.
5. Rode em semanas inteiras e não mexa no meio
Nada de trocar a divisão de tráfego, editar a variação ou mudar a campanha que alimenta a página durante o teste. Cada mudança no meio contamina a comparação.
6. Decida e registre o aprendizado
Ao atingir a amostra, decida: implantar, descartar ou refazer com outra hipótese. E registre — hipótese, números, resultado e o que se aprendeu. Um histórico de testes perdidos é tão valioso quanto o de testes ganhos, porque evita repetir a mesma aposta.
Quais ferramentas usar depois do fim do Google Optimize?
Uma parte dos guias ainda indica o Google Optimize como a opção gratuita para começar. Ele não existe mais.
Na prática, as opções se dividem em três grupos:
- Plataformas dedicadas de experimentação, como as três citadas pelo Google, com editor visual, estatística própria e integração com o GA4. São o caminho para quem tem tráfego e roda testes com frequência.
- Testes nativos das ferramentas que você já usa: os experimentos do Google Ads, o teste A/B do Gerenciador de Anúncios da Meta, o envio dividido das plataformas de e-mail e o teste de landing page de ferramentas de automação de marketing. Custam zero a mais e resolvem boa parte dos casos.
- Implementação própria, com a divisão feita no código do site e a medição no GA4. Exige desenvolvimento e cuidado com a estatística, mas não depende de licença.
A ferramenta, porém, é a parte menos importante da decisão. Nenhuma delas cria tráfego: se a conta de amostra não fecha, a plataforma mais cara do mercado vai só mostrar, com mais precisão, que o teste não teve poder estatístico.
Quais os erros mais comuns em teste A/B?
- Encerrar no primeiro dia "significativo". É o erro mais caro, porque produz vencedores falsos que a equipe implanta com convicção.
- Testar muitas versões com pouco tráfego. Cada versão extra divide o público; quatro versões pedem o dobro do tráfego de duas.
- Testar detalhes em página de pouco volume. Cor de botão exige efeito pequeno detectável, e efeito pequeno exige amostra enorme.
- Rodar menos de uma semana. O público do fim de semana não é o do meio da semana.
- Mudar a campanha ou a página no meio do teste. O que muda depois do início contamina os dois grupos de forma diferente.
- Olhar só a métrica intermediária. Mais cliques no botão com menos leads no fim é derrota, não vitória.
- Não registrar os testes perdidos. Sem histórico, a mesma hipótese volta seis meses depois.
Boa parte desses erros nasce antes do teste, numa página que já tem problemas visíveis sem experimento algum. Vale passar pela checagem de landing page antes: o que é erro óbvio se corrige, não se testa.
Como medir se o teste deu certo?
- A amostra planejada foi atingida, em semanas inteiras, sem interrupções nem mudanças no meio.
- A métrica principal mostra diferença com a significância definida antes (95% é o padrão mais comum; a Optimizely declara vencedor a partir de 90% por padrão).
- O tamanho do efeito paga a implantação. Uma melhora real de 2% pode não compensar o custo de refazer a página.
- As métricas de acompanhamento não pioraram: mais leads com leads piores, ou mais vendas com mais devoluções, não é ganho.
- O resultado se sustenta depois de implantado. Acompanhe a conversão da versão vencedora nas semanas seguintes; se o ganho some, o teste provavelmente estava sem poder estatístico.
Por onde começar hoje?
Comece pela conta, não pela ferramenta. Pegue as três páginas mais importantes do funil, anote o tráfego semanal e a conversão-base de cada uma, e use a tabela deste artigo para descobrir o tamanho de mudança que cada página comporta. Em muitos casos, a resposta será: só uma delas aguenta teste A/B, e só de mudança grande.
Essa é uma boa notícia, porque concentra o esforço. Para a página que aguenta, monte a hipótese e rode o teste com disciplina. Para as outras, use evidência qualitativa e corrija o que é óbvio. O trabalho de CRO — otimização de conversão da Alliance segue essa ordem: diagnóstico do funil, hipóteses priorizadas por impacto e tráfego, e só então experimentos. E se você quer um retrato de onde o marketing da empresa perde mais resultado antes de decidir o que testar, o diagnóstico gratuito de marketing avalia presença digital, aquisição e conversão em conjunto.