Entre os agentes de programação com IA, o OpenCode ocupa um lugar próprio: não pertence a um fabricante de modelo. Ele é o “motor” que lê o projeto, edita arquivos e roda comandos, e deixa a escolha do modelo para quem usa. Isso explica boa parte da popularidade e também a maior parte das dúvidas sobre custo e segurança.
Os textos que aparecem no topo da busca costumam celebrar o projeto como “aberto e privado” e listar recursos. Este artigo faz outra coisa: separa as três contas que compõem o custo real, explica o que a frase “não armazena seu código” cobre e o que ela não cobre, e entrega a lista do que uma empresa deveria configurar antes de liberar o OpenCode para o time. Tudo com base na documentação oficial, consultada em 10/11/2026.
O que é o OpenCode?
O OpenCode é um agente de código aberto: um programa que recebe um pedido em linguagem natural (“crie o endpoint de cadastro”, “ache o bug deste teste”), lê os arquivos do projeto, propõe e aplica mudanças e executa comandos no terminal. O código do próprio agente está publicado no GitHub, sob licença MIT, o que permite usar, modificar e distribuir sem pagar licença.
Ele roda em várias interfaces: no terminal (a forma mais conhecida), num aplicativo de desktop para macOS, Windows e Linux, num aplicativo móvel em teste e por um SDK que permite usá-lo dentro de scripts e rotinas de integração contínua. A instalação é por linha de comando, via npm, Bun, Homebrew ou script do site.
Vale um cuidado com o nome: “opencode” também aparece em buscas por outros produtos e projetos. Aqui, o assunto é o agente de programação mantido pela empresa Anomaly, publicado em github.com/anomalyco/opencode. A versão atual da documentação é a V2, que mudou nomes de configuração em relação à V1; quem segue tutorial antigo encontra chaves que já não existem.
O OpenCode é gratuito?
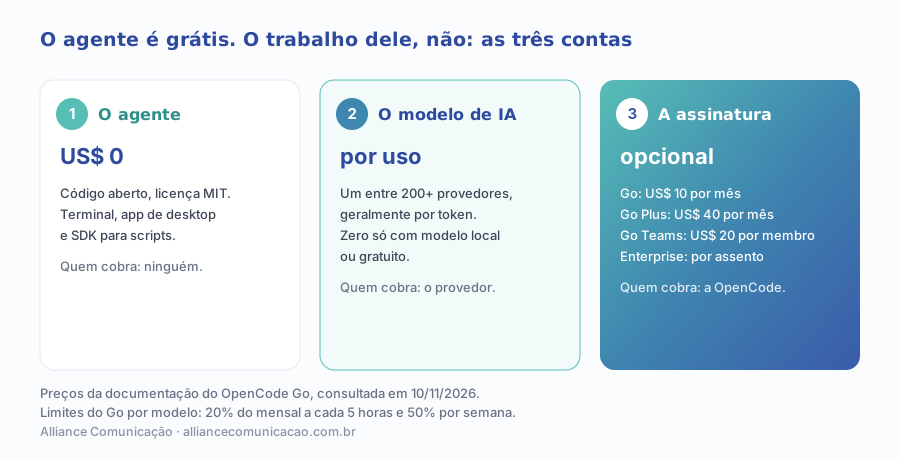
O agente é gratuito. O trabalho que ele faz, não. Cada pedido gera chamadas a um modelo de IA, e essas chamadas são cobradas por alguém. Na prática, o custo do OpenCode se divide em três contas independentes, e confundir uma com a outra é a origem da maioria das surpresas na fatura.
| Conta | Quem cobra | Como cobra | Quando existe |
|---|---|---|---|
| O agente (OpenCode) | Ninguém | Licença MIT, sem custo | Sempre |
| O modelo de IA | O provedor escolhido (ou a própria OpenCode, no Go) | Por uso, geralmente por token | Sempre, salvo modelo local ou gratuito |
| OpenCode Go | OpenCode | Assinatura mensal com limites por modelo | Opcional, para quem não quer contratar provedor |
| Enterprise | OpenCode | Por assento; sem cobrança de token com gateway próprio | Opcional, para gestão central |
Elaborado pela Alliance Comunicação com base no site e na documentação do OpenCode (Go e Enterprise), consultados em 10/11/2026.
Há caminhos de custo zero de verdade: usar modelos gratuitos oferecidos dentro do próprio OpenCode ou rodar um modelo local no próprio computador. Ambos servem para testar e para tarefas simples. Para trabalho profissional em projetos grandes, o custo do modelo volta a aparecer, e é ele que precisa de orçamento.
Quanto custa o OpenCode Go?
O OpenCode Go é uma assinatura opcional que dá acesso a uma lista curada de modelos abertos e comerciais com uma única chave, sem precisar contratar cada provedor. A documentação descreve o serviço como pensado principalmente para usuários internacionais.
A regra dos três tetos merece atenção. Quem concentra o trabalho num único dia de entrega pode bater o limite de 5 horas muito antes do mensal. Quando o limite acaba, as requisições são bloqueadas, a menos que a conta tenha saldo no Console e o recurso Extra Usage esteja ligado, o que passa a cobrar o excedente por uso. Também é possível continuar com os modelos gratuitos.
Para empresas, o Console permite criar orçamentos mensais por workspace, por membro e por conta de serviço. Um pedido só passa se couber em todos os orçamentos que se aplicam a ele, e sem orçamento nenhum o gasto é ilimitado. Os orçamentos zeram no dia 1º de cada mês, às 00h UTC.
Quais modelos e provedores o OpenCode suporta?
Segundo o site oficial, mais de 200 provedores, via o catálogo Models.dev, incluindo modelos locais. Na prática, isso cobre os grandes laboratórios, os agregadores de modelos e servidores que a própria empresa hospeda. Também é possível apontar o OpenCode para um gateway interno de IA, que centraliza credenciais, registro e custo.
Essa liberdade é a principal vantagem do OpenCode e o principal ponto de governança. Se cada desenvolvedor pode conectar qualquer provedor com a própria chave, a empresa perde a visão de para onde o código está indo. A documentação de políticas resolve isso com uma regra de provider.use: um provedor negado desaparece do catálogo e da seleção de modelos, mesmo que a pessoa tenha credencial válida.
A página Enterprise vai além: com uma configuração central, integrada ao login corporativo (SSO), é possível fazer todos os usuários acessarem só o gateway interno e desligar os demais provedores.
O OpenCode guarda o meu código?
Pela documentação, o próprio OpenCode não. O que acontece com o código depende de duas coisas que ficam fora do agente: o provedor de modelo escolhido e as páginas de compartilhamento.
A página de compartilhamento é o recurso que transforma uma conversa com o agente num link para mostrar a um colega. Útil para pedir ajuda, mas a conversa carrega trechos do código, nomes de arquivo, mensagens de erro e, às vezes, dados que estavam no terminal. É por isso que a recomendação existe. Em 10/11/2026, a documentação da V2 não traz mais a página específica sobre compartilhamento, enquanto a página Enterprise mantém a recomendação; ou seja, o recurso está em mudança, e a empresa deve conferir como ele se comporta na versão instalada antes de liberar.
O segundo ponto é o provedor. Quem usa a própria chave segue a política de dados do provedor contratado. Quem usa o Go segue a tabela de privacidade da OpenCode, que varia por modelo: a maioria tem retenção zero, alguns retêm por 30 dias, e alguns modelos identificados como “Contributor” treinam com os dados enviados. Por padrão, o workspace bloqueia endpoints pagos que treinam com os dados da requisição, e só alguém com permissão pode liberar.
Qual a diferença entre os agentes build e plan do OpenCode?
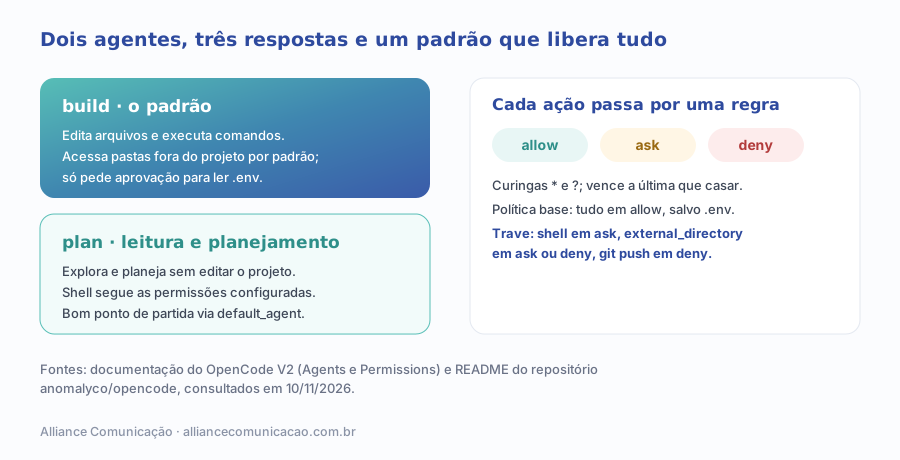
O OpenCode vem com dois agentes principais que se alternam durante o trabalho, além de subagentes de apoio. A diferença entre eles é de permissão, não de inteligência: os dois podem usar o mesmo modelo.
A documentação da V2 detalha um pouco mais. O build permite ferramentas e acesso fora da pasta do projeto por padrão, e só pede aprovação para ler arquivos sensíveis de ambiente (.env). O plan explora e planeja sem editar os arquivos do projeto, pode gravar arquivos de plano do próprio OpenCode, e os comandos de shell continuam sujeitos às permissões configuradas. Há ainda os subagentes general, para pesquisa em várias etapas, e explore, que busca e lê sem editar.
Como funcionam as permissões do OpenCode (allow, ask, deny)?
Cada ação do agente (ler, editar, rodar shell, buscar na web, acessar pasta externa, chamar ferramenta de um servidor MCP) passa por regras com três respostas possíveis: allow segue sem perguntar, ask espera a decisão de quem está usando, deny bloqueia. As regras aceitam curingas, são avaliadas em ordem e a última que casar vence.
O ponto que muda a conversa sobre segurança está na política base. Segundo a documentação de permissões, todo agente começa com uma regra que libera todas as ações em todos os recursos, seguida de exceções que pedem aprovação para ler arquivos .env. Em outras palavras: sem configuração própria, o agente build roda comandos e acessa pastas fora do projeto sem perguntar. A própria página avisa que nenhuma regra padrão pede aprovação para pastas externas.
A configuração recomendada pela documentação como exemplo segue a lógica inversa: shell em ask para tudo, e exceções em allow para comandos inofensivos, como git status e git diff, e em deny para o que nunca deve rodar sem humano, como git push. Comandos compostos são separados e cada parte é conferida.
Acima das permissões existem as políticas. Elas não perguntam: só permitem ou negam, e servem apenas para apertar o que as permissões liberariam. Políticas globais e as entregues pelo Console da empresa se sobrepõem à configuração do projeto, e uma aprovação salva pelo usuário nunca derruba um deny configurado.
O que a empresa precisa travar antes de liberar o OpenCode?
A lista abaixo transforma a documentação em decisões. Nenhum item exige plano pago; os que dependem do Console ou do Enterprise estão indicados.
1. Defina o provedor aprovado
Escolha um provedor, ou um gateway interno, cuja política de dados a empresa já avaliou. Use políticas de provider.use para negar os demais. No Enterprise, a configuração central com SSO força todos a passar pelo gateway.
2. Desligue o compartilhamento
Siga a recomendação da página Enterprise e confira, na versão instalada, se as conversas podem virar link. Registre a decisão no arquivo de configuração do repositório, para que valha para todo o time e não dependa da máquina de cada pessoa.
3. Faça do plan o ponto de partida
A configuração default_agent define qual agente abre a sessão. Começar em plan obriga uma etapa de leitura e planejamento antes de qualquer edição, e a troca para build vira uma decisão consciente.
4. Ponha shell em ask, com exceções curtas
Pergunte antes de rodar comandos, libere só os de leitura (status, diff, listagem, testes) e negue os que publicam ou apagam: push, deploy, remoção recursiva, migração de banco.
5. Feche as pastas externas
Configure external_directory em ask ou deny. Sem isso, o agente pode ler a pasta de chaves SSH ou outro projeto da mesma máquina.
6. Aprove MCP, skills e plugins por lista
As políticas têm ações próprias para servidores MCP, skills e plugins. Negue tudo e libere por nome o que foi revisado. Servidor MCP é uma porta que o agente abre para fora, como explica o artigo sobre o servidor MCP e a porta que o agente abre.
7. Ponha teto no gasto
Se o time usa o Console ou o Go, crie orçamentos por membro e por conta de serviço. Sem orçamento, o gasto é ilimitado. Se usa chave de provedor, configure o limite no painel do provedor.
Qual a diferença entre OpenCode, Copilot e Cursor?
Os três fazem trabalho parecido, mas o modelo de negócio é diferente, e é isso que muda a governança. O GitHub Copilot e o Cursor vendem assento com o modelo embutido e o controle administrativo concentrado no painel do fornecedor. O OpenCode separa o agente do modelo e põe o controle num arquivo de configuração.
| OpenCode | GitHub Copilot | Cursor | |
|---|---|---|---|
| O que é | Agente aberto, para terminal, desktop e SDK | Assistente do GitHub no editor, no chat e em PRs | Editor de código com IA integrada |
| Licença do agente | Código aberto (MIT) | Proprietária | Proprietária |
| Modelo de IA | Qualquer um entre 200+ provedores, ou local | Os oferecidos pelo GitHub | Os oferecidos pelo Cursor |
| Como se paga | Modelo por uso; Go e Enterprise opcionais | Assento por usuário mais uso | Assento por usuário mais uso |
| Onde mora o controle | Arquivo de configuração e políticas (Console no Enterprise) | Painel da organização no GitHub | Painel de administração do Cursor |
| Ponto de atenção | Política base libera tudo; precisa configurar | O que o assento não cobre | Privacidade depende do plano |
Comparativo da Alliance Comunicação com base na documentação de cada ferramenta e nos artigos do blog sobre Copilot e Cursor.
Quem já avaliou as outras ferramentas encontra o detalhe de cada uma nos artigos sobre as permissões que a empresa define no Claude Code e sobre o que ligar antes de liberar o Cursor. A lógica de governança é a mesma; muda onde fica o botão.
Quais os riscos de usar o OpenCode na empresa?
- Instalar e usar com a configuração padrão. A política base libera todas as ações; o agente executa comandos e mexe fora do projeto sem perguntar.
- Cada pessoa com a própria chave de provedor. O código vai para lugares que a empresa não escolheu, e o gasto fica espalhado em cartões pessoais.
- Compartilhar conversa sem pensar no conteúdo. Um link de conversa pode levar trecho de código, caminho de servidor e mensagem de erro com dado sensível.
- Escolher modelo do Go sem olhar a tabela de privacidade. Retenção e treino variam por modelo.
- Instalar plugin ou servidor MCP sem revisão. Eles ampliam o que o agente alcança, e um conteúdo malicioso lido pelo agente pode tentar usá-los.
- Seguir tutorial da V1 na V2. Nomes como bash e task mudaram para shell e subagent; regra escrita com o nome antigo pode não valer.
- Não pôr teto no gasto. Sem orçamento, o consumo não tem limite.
O risco de conteúdo malicioso merece uma leitura à parte: um agente que lê páginas, issues e arquivos de terceiros pode receber instruções escondidas nesse material. O artigo sobre prompt injection e a ordem escondida no que o agente lê mostra como isso acontece.
Por onde começar com o OpenCode?
- Teste num repositório sem dado sensível, com o agente plan e um modelo gratuito ou local.
- Escreva o arquivo de configuração do time: provedor aprovado, shell em ask com exceções, pastas externas fechadas, MCP e plugins por lista.
- Confira o comportamento do compartilhamento na versão instalada e desligue-o.
- Defina orçamento por pessoa, no Console ou no painel do provedor.
- Libere para um grupo pequeno por algumas semanas e meça tempo de entrega e qualidade dos pull requests.
- Só então amplie, com o arquivo de configuração versionado no repositório.
Adotar agente de código é menos uma escolha de ferramenta e mais uma decisão de processo: quem revisa o que o agente fez, o que ele pode tocar, quanto pode gastar. É esse desenho que a Alliance faz no serviço de desenvolvimento assistido por IA. E, se a dúvida é anterior, sobre onde a tecnologia entra na operação da empresa, o diagnóstico de marketing gratuito, que leva cerca de 30 minutos, inclui a dimensão de tecnologia e automação.