Quase todo time de marketing chega ao BigQuery pelo mesmo caminho: o GA4 começa a limitar o relatório, alguém liga a exportação, e o painel no Looker Studio ou no Power BI passa a ler do warehouse. Os primeiros meses saem de graça. Até o dia em que chega uma fatura que ninguém sabe explicar.
Este guia explica o que é o BigQuery e, principalmente, como ele cobra cada consulta: por que a conta acompanha os bytes lidos e não as linhas devolvidas, por que o LIMIT não ajuda, e quais travas colocar antes de entregar o acesso ao time e aos painéis.
O que é o BigQuery?
O BigQuery é o data warehouse gerenciado do Google Cloud. Ele guarda grandes volumes de dados em tabelas e responde perguntas sobre eles em SQL, sem que a empresa precise instalar servidor, dimensionar máquina ou cuidar de backup. Você carrega os dados, escreve a consulta e paga pelo uso.
Duas características explicam quase tudo o que vem depois. A primeira: o armazenamento é colunar, ou seja, cada coluna da tabela fica guardada separada das outras. A segunda: a cobrança padrão das consultas é proporcional ao volume de dados que a consulta precisa ler. Juntas, elas fazem com que a mesma pergunta possa custar centavos ou dezenas de dólares, dependendo de como foi escrita.
Em marketing, o uso mais comum é receber a exportação de eventos do Google Analytics 4, os dados de mídia do Google Ads e as vendas do CRM, e servir de base para os painéis. Se a dúvida ainda é se a empresa precisa de um warehouse, o ponto de partida é o nosso guia sobre quando o marketing precisa de um data warehouse. Aqui o assunto é o passo seguinte: o BigQuery já está em uso, e a conta precisa ficar sob controle.
O que é uma consulta no BigQuery e qual o papel do SQL?
Uma consulta é um pedido escrito em SQL, a linguagem padrão de bancos de dados, que diz quais colunas buscar, de quais tabelas, com quais filtros e agrupamentos. No BigQuery, cada consulta vira um job: um trabalho com registro próprio de duração, bytes processados e bytes faturados.
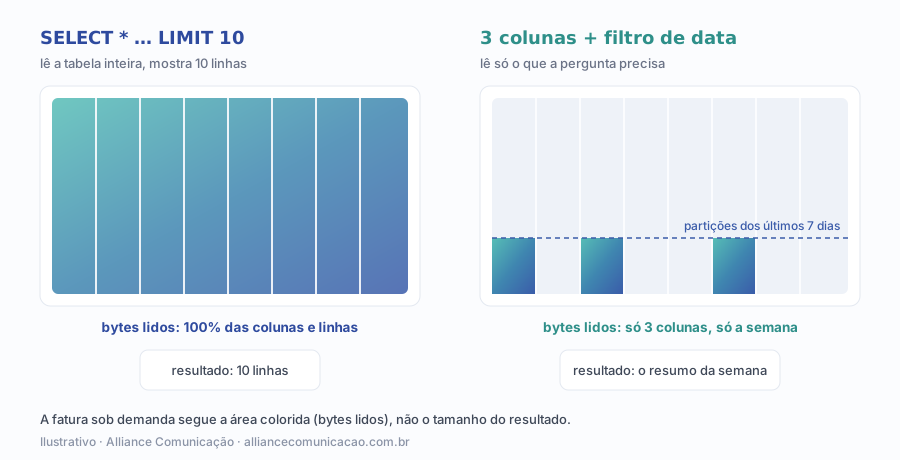
Uma consulta típica de marketing pergunta, por exemplo, quantas sessões e conversões cada campanha gerou na última semana. Em SQL, isso é um SELECT com três ou quatro colunas, um filtro de data e um GROUP BY por campanha. Escrita assim, ela lê pouco. Escrita como SELECT * "para ver o que tem", ela lê a tabela inteira.
O SQL do BigQuery é o GoogleSQL, compatível com o padrão ANSI e com funções próprias para datas, textos, arrays e estruturas aninhadas, que aparecem bastante na exportação do GA4, onde os parâmetros de cada evento vêm dentro de um campo repetido. Quem já escreve SQL em outro banco se adapta rápido; o que muda é o cuidado com custo.
Como acessar e usar o BigQuery gratuito?
O acesso é pelo console do Google Cloud, no menu BigQuery, com uma conta Google. Há dois caminhos sem custo. O sandbox dispensa cartão de crédito, mas impõe limites próprios, como a expiração automática das tabelas, tema que detalhamos no guia de data warehouse. A camada gratuita vale para qualquer projeto com faturamento ativo e se renova todo mês.
Na camada gratuita, segundo a página oficial de preços, o primeiro 1 TiB de dados processados em consultas e os primeiros 10 GiB de armazenamento por mês não são cobrados. Para muita empresa pequena, isso cobre o uso inteiro. O problema é que esse 1 TiB some depressa quando um painel com consultas mal desenhadas atualiza várias vezes por dia.
Como o BigQuery cobra uma consulta?
Existem dois modelos de cobrança de processamento. No sob demanda, o padrão, você paga por TiB processado. No de capacidade, você paga por slot-hora, que é tempo de máquina reservado, independentemente de quantos bytes a consulta lê. Quase toda equipe de marketing começa, e fica, no sob demanda.
| Sob demanda (por TiB) | Capacidade (por slot-hora) | |
|---|---|---|
| Você paga por | Bytes lidos pelas consultas | Tempo de processamento reservado |
| Gratuidade | 1 TiB de consultas por mês | Não se aplica ao processamento |
| Previsibilidade | Varia com o volume e a qualidade das consultas | Mais previsível, ligada à reserva |
| Faz sentido para | Uso eventual, painéis de marketing, times pequenos | Volume alto e constante de consultas |
| Risco típico | Consulta mal escrita lendo a tabela toda | Pagar por capacidade ociosa |
Comparativo da Alliance Comunicação com base na página oficial de preços do BigQuery (Google Cloud), consultada em 10/11/2026.
No sob demanda, a página de preços detalha regras que pesam na conta. Você é cobrado pelo total de dados nas colunas que seleciona, e o tamanho de cada coluna depende do tipo de dado. A cobrança é arredondada para cima, em MB, com mínimo de 10 MB por tabela referenciada e de 10 MB por consulta. Consultas que terminam em erro e resultados servidos pelo cache não são cobrados.
Há também um detalhe que pega muita gente: cancelar uma consulta em andamento pode gerar cobrança de até o custo total dela, segundo a página de preços. Ou seja, o botão de cancelar não é trava de custo. A trava precisa vir antes de rodar.
Quanto custa o BigQuery depois da camada gratuita?
Na multirregião US, a conta de processamento sob demanda é direta: bytes processados no mês, menos o 1 TiB gratuito, vezes US$ 6,25 por TiB. Outras regiões, como São Paulo, têm tabela própria na mesma página, e quem paga em outra moeda segue os valores dos SKUs do Google Cloud. Antes de projetar o orçamento, confira o preço da região em que o seu conjunto de dados está.
Para enxergar a ordem de grandeza, vale um exemplo ilustrativo, com números hipotéticos. Imagine um painel com uma consulta que lê 50 GiB a cada atualização e que roda 30 vezes por dia, entre abertura de página, troca de filtro e atualização agendada. São cerca de 1.500 GiB por dia e aproximadamente 44 TiB em um mês de 30 dias. Descontado o 1 TiB gratuito, a fatura de processamento ficaria perto de US$ 268 no mês, só por esse painel.
Agora imagine a mesma pergunta reescrita para ler três colunas e só os últimos sete dias, caindo para 2 GiB por execução. As mesmas 30 execuções diárias somariam cerca de 1,8 TiB no mês, e quase tudo cairia dentro da gratuidade. A diferença não está no BigQuery: está no desenho da consulta e da tabela.
O armazenamento costuma pesar menos que o processamento em marketing. A página de preços separa armazenamento ativo e de longo prazo, este para tabelas ou partições sem alteração por 90 dias consecutivos, com preço menor. Em tabelas particionadas, cada partição é avaliada separadamente para entrar no longo prazo.
Por que o LIMIT não deixa a consulta mais barata?
Porque o LIMIT age sobre o resultado, e o BigQuery cobra pela leitura. Em um banco colunar, para devolver as dez primeiras linhas de um SELECT *, o motor ainda precisa ler todas as colunas citadas, em todas as linhas da tabela, e só depois corta o que vai mostrar. A cobrança acompanha o que foi lido, não o que apareceu na tela.
A própria documentação é explícita: em tabelas não clusterizadas, aplicar LIMIT não altera a quantidade de dados lidos, e por isso não deve ser usado como controle de custo. A página de preços repete a regra: você é cobrado pelos dados das colunas selecionadas mesmo com um LIMIT explícito.
Existe uma exceção. Em tabelas clusterizadas, o LIMIT pode reduzir os bytes lidos, porque o motor consegue parar de varrer blocos depois de juntar linhas suficientes. Ainda assim, a estimativa prévia para tabela clusterizada é um teto, e não o valor final; a economia só aparece depois da execução.
Para só espiar o conteúdo de uma tabela, a saída certa é a pré-visualização: a aba Prévia do console, o comando bq head ou o método tabledata.list. A documentação informa que essas opções mostram os dados sem custo e sem consumir cota. É o substituto direto do SELECT * LIMIT 10.
Como estimar o custo antes de rodar a consulta?
Com o dry run, a execução simulada. Ele valida a consulta e devolve quantos bytes ela processaria, sem rodar de fato. No console, o validador faz isso enquanto você digita, e mostra no canto do editor quanto a consulta vai processar. Na linha de comando, o bq query aceita a opção --dry_run; na API, o job tem o parâmetro dryRun.
Com os bytes em mãos, a conta é simples: divida por 1 TiB e multiplique pelo preço da sua região. Uma consulta que vai processar 200 GiB consome perto de um quinto da gratuidade mensal de uma vez. Se ela vai para um painel que atualiza de hora em hora, multiplique por 24 antes de aprovar.
A documentação faz uma ressalva importante: a estimativa de bytes faturados é um limite superior. O valor real pode sair menor, principalmente em tabela clusterizada. Para orçamento, isso é bom: se o teto cabe, o real também cabe.
Como travar o teto de bytes e a cota diária?
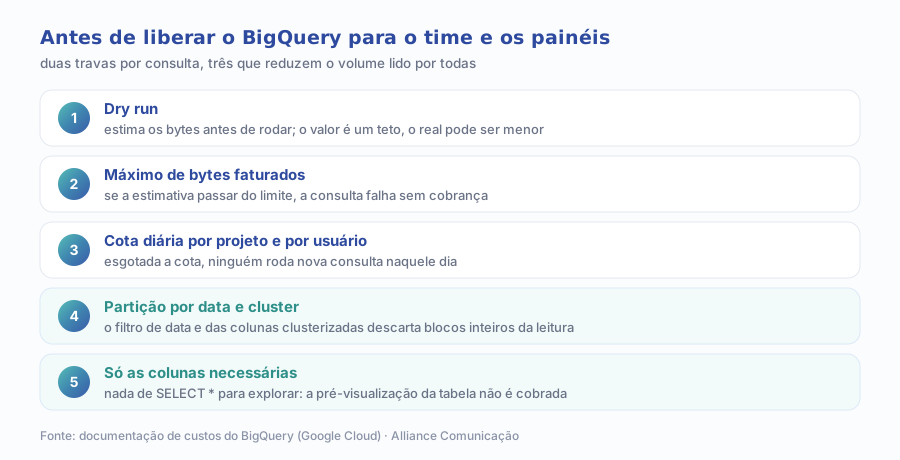
Estimar ajuda quem lembra de olhar. As travas protegem de quem não lembra, inclusive dos painéis, que rodam consultas sozinhos. O BigQuery oferece duas, e as duas valem a pena ligar antes de abrir o acesso ao time.
1. Máximo de bytes faturados por consulta
É um limite por consulta. Se a estimativa ultrapassar o valor definido, a consulta falha sem gerar cobrança. Ele pode ser definido nas configurações da consulta, no console, ou como parâmetro no job. A documentação avisa: como a estimativa em tabela clusterizada é um teto, a consulta pode falhar mesmo quando o valor real ficaria abaixo do limite. Calibre com folga.
2. Cota personalizada diária por projeto e por usuário
É um limite de volume processado por dia, no projeto inteiro ou por usuário. Quando a cota acaba, o usuário não consegue mais rodar consultas naquele dia. Para marketing, a combinação que funciona é uma cota de projeto que caiba no orçamento mensal dividido por 30 e uma cota por usuário mais apertada para quem está aprendendo.
3. Alerta de orçamento no faturamento
O alerta de orçamento do Cloud Billing não bloqueia nada, mas avisa por e-mail quando o gasto passa de percentuais definidos. Ele completa as duas travas: o teto e a cota impedem o estrago grande; o alerta mostra a tendência antes do fim do mês.
Como desenhar a tabela para cada consulta ler menos?
As travas evitam o pior. O que derruba o custo de forma permanente é o desenho da tabela, porque ele vale para todas as consultas, de todas as pessoas e de todos os painéis.
1. Particione por data
Uma tabela particionada por data guarda cada dia em um bloco separado. Uma consulta com filtro na coluna de partição lê só os dias pedidos. A página de preços recomenda usar partição e cluster sempre que possível, justamente porque reduzem o volume processado. Vale ativar a opção que exige filtro de partição, para impedir a consulta que esquece a data.
2. Clusterize pelas colunas mais filtradas
O cluster ordena os dados dentro da tabela por até algumas colunas, como nome do evento ou campanha. Quando a consulta filtra por elas, o BigQuery usa o filtro para descartar blocos e ler menos bytes. É também o que faz o LIMIT poder ajudar.
3. Na exportação do GA4, filtre o sufixo da tabela
A exportação do GA4 não cria uma tabela particionada: ela cria uma tabela por dia, com nome events_AAAAMMDD, e uma tabela intraday para o dia corrente, segundo a Central de Ajuda do Analytics. Consultas com curinga, como events_*, devem filtrar a pseudocoluna _TABLE_SUFFIX com valores constantes. A documentação diz que isso reduz muito os bytes varridos, mas que condições sem expressão constante não limitam as tabelas lidas.
Dois detalhes da mesma documentação pesam em painel. Consultas com curinga não usam o cache: rodar a mesma consulta várias vezes cobra todas as vezes. E o Google recomenda tabela particionada em vez de tabela fatiada por data, por desempenho. Por isso, muitas equipes copiam os eventos do GA4 para uma tabela particionada e clusterizada, e apontam os painéis para ela.
4. Materialize o resultado em etapas
A documentação recomenda materializar resultados em etapas: em vez de o painel ler os eventos brutos, uma consulta agendada grava um resumo diário por campanha e canal numa tabela pequena, e o painel lê o resumo. Consultar a tabela menor reduz a quantidade de dados lidos, e o custo do cálculo pesado é pago uma vez por dia, não a cada clique.
Como ligar Power BI, Looker Studio e Excel sem multiplicar o custo?
Os painéis são a maior fonte de consultas repetidas, porque ninguém vê o SQL que eles disparam. A regra é a mesma para qualquer ferramenta: o painel deve ler uma tabela pequena e resumida, e o número de leituras deve ser controlado.
- Power BI: o conector nativo do Google BigQuery permite importar os dados ou consultar em tempo real (DirectQuery). Na importação, o BigQuery é lido na atualização agendada; no DirectQuery, cada interação com o relatório pode virar consulta. Para marketing, importar uma tabela resumida costuma bastar. A questão da licença está no guia de quem paga para ver o painel no Power BI.
- Looker Studio: o conector do BigQuery consulta a fonte quando o relatório é aberto ou filtrado, com cache próprio de curta duração. Aponte para a tabela resumida, nunca para events_* com o período livre. Os limites da ferramenta estão no guia sobre onde o Looker Studio gratuito trava.
- Excel: o caminho comum é o driver ODBC do BigQuery ou o conector do Power Query, quando disponível na sua versão. Nos dois casos, prefira exportar o resultado de uma consulta já filtrada a puxar a tabela bruta para a planilha.
- Agendamento: desligue atualizações de hora em hora em painel que ninguém consulta de madrugada. Uma atualização diária no início do expediente costuma atender o marketing.
Desenhar essa camada, das tabelas resumidas aos painéis que o time realmente lê, é o trabalho do nosso serviço de BI e dashboards para marketing: o painel nasce com custo previsto, não com fatura surpresa.
Quais os erros que mais encarecem a conta?
| Erro | Por que encarece | O que fazer no lugar |
|---|---|---|
| SELECT * para explorar | Lê todas as colunas da tabela | Usar a pré-visualização, que não é cobrada |
| LIMIT como controle de custo | Em tabela comum, não reduz a leitura | Selecionar colunas e filtrar a partição |
| events_* sem filtro de _TABLE_SUFFIX | Lê todos os dias exportados | Filtrar o sufixo com datas constantes |
| Painel lendo eventos brutos | Cada clique refaz o cálculo pesado | Materializar um resumo diário |
| Atualização de hora em hora | Multiplica as leituras por 24 | Atualizar uma vez por dia |
| Nenhum teto definido | Uma consulta errada consome o mês | Máximo de bytes faturados e cota diária |
Elaborado pela Alliance Comunicação com base na documentação oficial de custos e de tabelas curinga do BigQuery (Google Cloud), consultada em 10/11/2026.
Um erro menos visível é confiar no cancelamento. Como a própria página de preços avisa, cancelar uma consulta em andamento pode gerar cobrança de até o custo total. Outro é esquecer o mínimo de 10 MB por tabela: consultas pequenas e muito frequentes, juntando várias tabelas, somam mais do que parecem.
Por fim, há o erro de organização: todo mundo usando o mesmo projeto, sem cota por usuário. Quando a fatura chega, não há como saber quem gerou o quê. O histórico de jobs mostra os bytes de cada consulta, mas só ajuda se alguém olhar.
Por onde começar hoje
Se o BigQuery já está ligado ao GA4 e aos painéis, comece pela ordem que protege mais com menos esforço:
- Abra o histórico de jobs do projeto e ordene pelos bytes faturados para achar as consultas mais caras.
- Defina o máximo de bytes faturados nas consultas manuais e uma cota diária por usuário.
- Troque todo SELECT * de exploração pela pré-visualização da tabela.
- Revise as consultas sobre events_* e garanta o filtro de _TABLE_SUFFIX com datas constantes.
- Crie uma tabela resumida, particionada por data, e aponte os painéis para ela.
- Ajuste a atualização dos painéis para a frequência que o time de fato usa.
- Ligue um alerta de orçamento no faturamento e acompanhe o primeiro mês.
Se a dúvida é maior que o custo, e passa por quais dados juntar, quais indicadores acompanhar e quanto investir em cada canal, o diagnóstico de marketing gratuito da Alliance leva cerca de 30 minutos e mostra onde dados e mensuração estão travando o resto do plano.