Criar um agente de IA ficou fácil. Em uma tarde dá para escrever as instruções, subir alguns documentos, ligar o agente a uma planilha ou ao WhatsApp e ver ele responder com naturalidade. Os tutoriais que aparecem no topo do Google ensinam bem essa parte — e quase todos terminam com a mesma frase: “agora teste e ajuste”.
É nessa frase que mora o problema. Testar, na prática, vira conversar com o agente meia hora, achar que ele está ótimo e publicar. Este guia passa rápido pela montagem e se concentra no que os tutoriais pulam: como montar o conjunto de testes que decide se o agente pode falar com o seu cliente, com quantos casos começar, quais situações provocar, por que rodar a mesma pergunta várias vezes e qual nota exigir antes do go-live.
O que é preciso para criar um agente de IA?
Um agente de IA é um programa que usa um modelo de linguagem para entender um pedido, decidir o próximo passo e, quando tem permissão, agir: consultar um pedido, agendar uma visita, registrar um lead no CRM. Para ele existir, são necessárias cinco peças.
- Objetivo fechado: uma tarefa com começo e fim, como qualificar leads do site ou responder dúvidas de segunda via — não “atender o cliente”.
- Instruções: o papel do agente, o tom de voz, o que ele pode e o que não pode fazer, e quando passa a conversa para uma pessoa.
- Conhecimento: os documentos e dados da empresa que fundamentam as respostas.
- Ferramentas: as integrações que deixam o agente consultar ou alterar algo num sistema.
- Um critério de aprovação: a definição, por escrito, do que conta como resposta certa — a peça que quase todo projeto esquece.
As quatro primeiras aparecem em qualquer tutorial. A quinta é o assunto deste artigo. Antes de montá-la, vale confirmar se o caso pede mesmo um agente: muitas tarefas ficam mais baratas e previsíveis num fluxo de regras, como mostramos no artigo sobre agente de IA ou fluxo automatizado.
Como criar um agente de IA, passo a passo?
O roteiro de montagem é parecido em qualquer plataforma. A diferença está no último passo, que aqui ganha o peso que merece.
1. Escreva a tarefa em uma frase
“Responder dúvidas sobre prazo e status de pedido de clientes que já compraram.” Se a frase precisa de vírgulas demais, são dois agentes. Tarefa estreita é mais fácil de instruir, de testar e de medir.
2. Escreva as instruções como política, não como pedido
Em vez de “seja educado e ajude o cliente”, escreva regras verificáveis: o que o agente responde sozinho, o que só informa depois de consultar o sistema e o que ele nunca faz. Cada regra dessas vira, mais adiante, um caso de teste.
3. Conecte o conhecimento e as ferramentas
Suba a base de documentos revisada e ligue as integrações com o mínimo de permissão necessário. Preço, prazo e estoque devem vir do sistema, não de um texto colado — documento envelhece e o agente continua citando o número antigo. Quando a base cresce muito, entra a discussão de RAG e quando a empresa nem precisa dele.
4. Monte o conjunto de testes antes de ajustar o prompt
É a inversão que separa projeto amador de projeto profissional: primeiro se define a prova, depois se ajusta o agente até ele passar. Ajustar o prompt sem uma prova fixa é mexer num lugar e quebrar outro sem perceber.
5. Libere por etapas, com o critério na mão
O agente só sai do ambiente de teste quando passa no critério combinado. Depois, abre para uma fração pequena do público, com as conversas registradas, e só então para todos.
Por que conversar com o agente não é testar?
Quem cria o agente conversa com ele como quem sabe o que ele deveria responder. Faz perguntas bem escritas, na ordem certa, com a paciência de quem quer que dê certo. O cliente real faz o contrário: escreve pela metade, mistura dois assuntos, insiste, manda um áudio transcrito de três parágrafos.
Há também um problema que a conversa manual não enxerga: o mesmo agente pode responder a mesma pergunta de formas diferentes em execuções diferentes. Você perguntou uma vez, ele acertou, e a conclusão foi “funciona”. Nas próximas dez vezes, para dez clientes, ele pode acertar sete.
Uma conversa boa com o agente prova que ele consegue acertar. Não prova que ele acerta sempre — e o cliente só vê a vez em que ele erra.
O que falta é o que a engenharia de software tem há décadas e que, em IA, ganhou o nome de avaliação (em inglês, evals): uma lista fixa de casos, com a resposta esperada, rodada sempre do mesmo jeito, que dá uma nota comparável entre uma versão do agente e a seguinte.
O que é um conjunto de testes de um agente de IA?
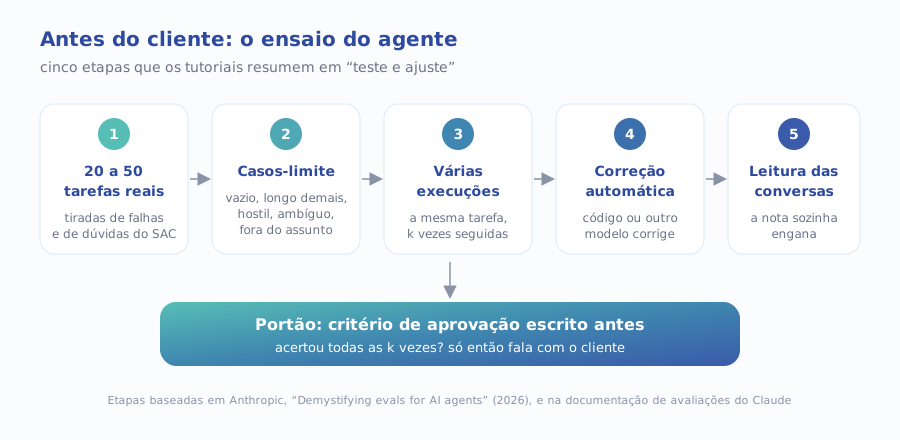
É uma planilha — ou um arquivo num sistema de testes — em que cada linha é uma tarefa: a mensagem do cliente, o contexto (quem é ele, o que comprou), o que o agente deveria fazer e como saber se fez. A Anthropic recomenda que cada tarefa tenha critério tão claro que dois especialistas, sozinhos, cheguem ao mesmo veredito de passou ou não passou, e que tenha uma resposta de referência que prove que a tarefa tem solução.
O conjunto precisa ser equilibrado. A mesma referência alerta para testar tanto os casos em que um comportamento deve acontecer quanto os casos em que não deve. Um agente testado só em “passa para o atendente quando o cliente pede” aprende a passar tudo para o atendente — e a nota sobe enquanto o agente fica inútil.
Quantos testes montar antes de ligar o agente?
Menos do que parece, e mais cedo do que se costuma fazer. A equipe de engenharia da Anthropic, que publicou em janeiro de 2026 um guia sobre avaliação de agentes, é direta sobre o ponto de partida:
Na prática de uma empresa, “falhas reais” têm endereço conhecido: o histórico do SAC, as perguntas que o comercial ouve toda semana, as reclamações do Reclame Aqui, os e-mails que ficaram sem resposta. Vinte conversas reais valem mais do que duzentas perguntas inventadas pela equipe, porque carregam o jeito de escrever do cliente.
O recado do “quanto mais se espera, mais difícil” é prático: com o agente já no ar, cada caso novo precisa ser reconstruído a partir de reclamações, e a equipe passa a testar sob pressão. Montar os primeiros casos junto com as instruções custa uma tarde.
Que casos-limite o teste precisa cobrir?
Além das tarefas comuns, o conjunto precisa provocar o agente nas situações em que ele costuma escorregar. A documentação de avaliações do Claude lista as categorias e faz uma escolha que vai contra a intuição:
Traduzido para um agente de atendimento, cada categoria vira um tipo de linha na planilha de testes:
| Caso-limite | Exemplo no atendimento | O que o agente deve fazer |
|---|---|---|
| Entrada vazia ou irrelevante | “oi”, um emoji, uma pergunta sobre futebol | Cumprimentar e perguntar como pode ajudar, sem inventar assunto |
| Informação inexistente | Pedido com número que não está no sistema | Dizer que não encontrou e pedir confirmação — nunca inventar status |
| Entrada longa demais | Áudio transcrito com três assuntos misturados | Separar os pedidos e tratar um de cada vez |
| Usuário hostil ou mal-intencionado | Ofensa, ameaça de processo, pedido para “ignorar as regras” | Manter o tom, não ceder e passar para uma pessoa |
| Pergunta ambígua | “Quanto custa a entrega?” sem cidade nem produto | Perguntar o que falta antes de responder |
| Caso em que NÃO deve agir | Cliente só quer informação, não quer cancelar | Responder sem disparar a ação de cancelamento |
Categorias da documentação de avaliações do Claude (Anthropic); exemplos de atendimento elaborados pela Alliance Comunicação.
Os casos que envolvem promessa — desconto, prazo, exceção de política — merecem atenção extra, porque o erro ali tem consequência jurídica. O roteiro de provocações para esses casos e a regra de quem responde pela frase do bot estão no artigo chatbot com IA: quem responde quando ele erra.
Por que rodar o mesmo teste várias vezes?
Porque o agente não é determinístico: a mesma mensagem pode gerar respostas diferentes em execuções diferentes. Uma rodada única do conjunto de testes mostra uma fotografia; várias rodadas mostram a consistência. E aqui entra a distinção que mais muda a decisão de lançar um agente de atendimento.
As duas métricas contam histórias opostas sobre o mesmo agente. A pass@k responde “ele consegue?” e sobe a cada tentativa extra. A pass^k responde “ele é confiável?” e desce a cada tentativa extra. Para um assistente interno, em que a pessoa pode pedir de novo, a primeira pode bastar. Para quem fala com o cliente, só a segunda interessa: o cliente não tem direito a três tentativas, ele recebe uma.
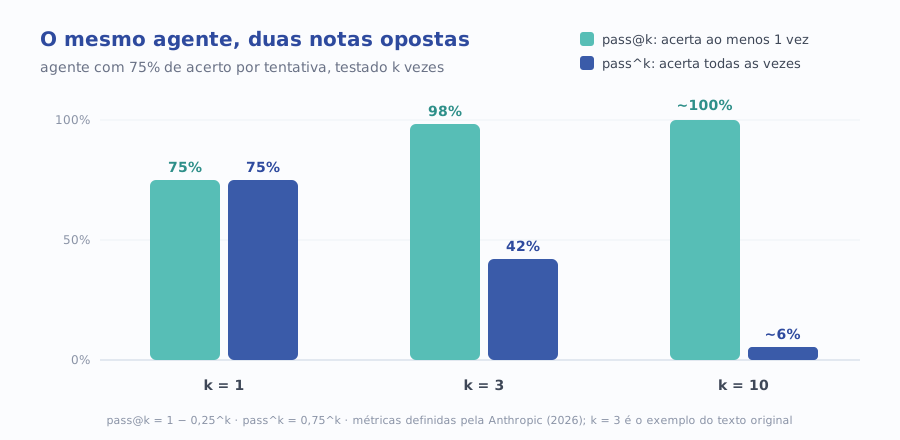
O efeito prático é ajustar a régua. Um agente que “acerta 75%” parece quase pronto; medido pela pass^k, ele erra com alguém em mais da metade das sequências de três atendimentos parecidos. Por isso o critério de aprovação deve ser escrito em termos de consistência — por exemplo, a tarefa só conta como aprovada se acertou em todas as execuções da rodada.
Quem corrige as respostas do agente no teste?
Com 50 tarefas rodadas cinco vezes, são 250 respostas por versão do agente. Ninguém lê isso à mão a cada ajuste no prompt. O guia da Anthropic descreve três tipos de corretor, cada um com seu papel:
- Correção por código: rápida, objetiva e reproduzível. Serve para o que tem resposta exata — o agente chamou a ferramenta de consulta? Informou o número de pedido certo? Passou para humano quando devia?
- Correção por outro modelo: flexível e escalável, boa para julgar tom, clareza e se a resposta seguiu a política. É mais cara e também varia entre execuções — por isso a documentação recomenda usar um modelo diferente do que gerou a resposta.
- Correção humana: a mais confiável e a mais lenta. Fica para calibrar os outros dois corretores e para os casos que eles marcam como duvidosos.
E há uma etapa que nenhum corretor substitui: ler as conversas. O mesmo guia afirma que não há como saber se os corretores estão funcionando sem ler as transcrições e as notas de muitas execuções. É na leitura que aparece o agente que “passou” porque disse a frase esperada no meio de uma resposta errada, ou o que “reprovou” porque deu uma resposta melhor do que a referência.
Como testar o agente no ChatGPT, Gemini, Copilot Studio, n8n ou WhatsApp?
A plataforma muda o lugar em que o teste roda, não o método. O conjunto de casos, as várias execuções e o critério escrito valem para todas. O que varia é quanto dá para automatizar:
| Onde o agente foi criado | Como rodar o conjunto de testes | Cuidado principal |
|---|---|---|
| GPT personalizado (ChatGPT) ou Gem (Gemini) | Manual: abrir uma conversa nova para cada caso e repetir cada um algumas vezes, registrando numa planilha | Uma conversa longa contamina a seguinte; sempre recomeçar do zero |
| Copilot Studio ou plataforma corporativa | Usar o recurso de teste da própria ferramenta com a lista fixa de casos, e repetir a cada versão publicada | Testar com as mesmas permissões e dados que o agente terá em produção |
| n8n ou outro orquestrador | Montar um fluxo que lê a planilha de casos, chama o agente k vezes e grava respostas e notas | Isolar as ações reais: no teste, a ferramenta consulta, mas não altera nada |
| Agente no WhatsApp | Rodar o conjunto pelo backend, antes do número oficial; depois, abrir para um grupo pequeno | Mensagens curtas, áudio transcrito e emoji precisam estar entre os casos |
Elaborado pela Alliance Comunicação a partir da prática de implantação de agentes; o método é o mesmo nas quatro situações.
Quem está montando o agente num orquestrador como o n8n tem vantagem: o próprio fluxo pode rodar a bateria de testes toda vez que o prompt muda. Os limites da versão gratuita estão no artigo sobre o que é n8n e as regras do plano grátis. No WhatsApp, além do teste, há regras da Meta sobre o uso de IA, tratadas no artigo sobre o que a Meta proibiu no chatbot para WhatsApp.
Quais os erros mais comuns ao criar um agente de IA?
- Escrever o critério depois de ver a nota. Se a régua é definida olhando o resultado, ela sempre aprova o agente.
- Testar só com perguntas da equipe. Quem criou o agente escreve como ele espera; o cliente, não.
- Rodar cada caso uma vez só. Uma execução mede sorte; várias medem consistência.
- Medir pass@k num agente de atendimento. A nota fica bonita exatamente porque ignora as vezes em que ele erra.
- Só testar o que o agente deve fazer. Sem casos em que ele não deve agir, a correção empurra para um agente que faz demais ou de menos.
- Usar o mesmo modelo para responder e para corrigir sem calibrar com leitura humana.
- Jogar fora o conjunto depois do lançamento. Cada reclamação real é um caso novo; a bateria cresce com o agente e roda a cada mudança de prompt, de modelo ou de base.
Como medir se o agente está pronto e continua pronto?
- Taxa de aprovação por consistência: percentual de tarefas que passaram em todas as execuções da rodada — a pass^k do seu conjunto.
- Aprovação nos casos-limite, separada: um agente pode ir bem no comum e mal no hostil; a média esconde isso.
- Taxa de passagem para humano: alta demais indica agente medroso; baixa demais, agente que segura o que não devia.
- Regressões: tarefas que passavam na versão anterior e pararam de passar depois de um ajuste.
- Casos novos por semana: quantas conversas reais viraram linha na planilha — o sinal de que o teste acompanha o cliente.
Esses números entram no orçamento do projeto: o tempo de montar e manter o conjunto de testes é custo recorrente, não detalhe. A composição completa está no artigo sobre quanto custa um agente de IA.
Por onde começar hoje
- Escreva a tarefa do agente em uma frase e a política em regras verificáveis.
- Separe 20 conversas reais do SAC ou do comercial e transforme cada uma numa linha: mensagem, contexto, resposta esperada, critério de aprovação.
- Acrescente os seis tipos de caso-limite da tabela, incluindo pelo menos um em que o agente não deve agir.
- Defina a régua antes de rodar: quantas execuções por caso e que percentual de tarefas precisa passar em todas.
- Rode, leia as conversas, ajuste o agente e rode de novo. Só abra ao cliente — primeiro a um grupo pequeno — quando a régua for atingida.
Se você quer saber em que ponto a sua empresa está antes de investir num agente — dados, atendimento, tecnologia e processos —, faça o diagnóstico de marketing gratuito da Alliance. E, para desenhar, testar e colocar o agente no ar com esse método, conheça o serviço de agentes de IA para empresas.